Appearance
系统性思维:组合技能、子智能体等
Claude Code 的各个组件都有详细文档记录。没有记录的是如何思考如何将它们组合起来。这篇文章关于的是思维方式,而非功能本身。
前提条件:本章假设你已经了解每个 Claude Code 组件是什么(内存、命令、技能、子智能体、Hooks、MCP、无头模式、SDK)。如果不了解,请先阅读 Claude Code 作为 AI 智能体框架。那一章涵盖是什么;这一章涵盖如何思考如何将它们组合起来。
从原语到组合
在 Claude Code 作为 AI 智能体框架中,你了解到 Claude Code 遵循 Unix 风格的设计哲学:一组小型原子工具(Read、Edit、Bash、Grep、Glob、WebFetch),通过 LLM 的推理循环组合,产生远超任何单一工具所能提供的涌现能力。智能体循环——感知、行动、验证——是引擎。三层工具架构(内置原语 → Bash 可达工具 → MCP 扩展)定义能力边界。分级权限模型定义安全边界。
那一章解释了每个部分的是什么和为什么。这一章关于如何——具体是,在面对真实的、模糊的工程问题时,如何思考将这些部分组合起来。
两者之间的关键洞见:涌现能力 = 原子工具 × LLM 推理 × 反馈循环。 同样的原则适用于编排层。内存、技能、子智能体、Hooks 和命令本身就是原语——每个回答不同的设计问题,每个都可以与其他组合。系统性思维者不会记忆组件目录,而是内化组合语法。
为什么叫"系统性思维"而非"如何使用 Claude Code"
你已经知道技能、子智能体、命令和 Hooks 是什么了。你读过文档,你可能构建过几个技能,也许连接过子智能体。但当你遇到新的、模糊的工程问题——比如"用安全检查、测试验证和 Jira 通知自动化我们的整个代码审查流水线"——你不是去找某个功能。你寻找的是一个思维框架,告诉你如何分解问题、将责任分配给正确的组件、定义它们之间的边界,以及预测系统将在哪里出故障。
这就是缺口所在。Claude Code 文档单独解释每个组件。它没有教你组合的架构直觉——看着一个复杂需求,立即看出哪些组件应该组合、以什么拓扑结构、它们之间有什么契约的能力。
这种直觉将构建提示词演示的人与交付可维护智能体系统的人区分开来。它也是——并非巧合——将知道每个 API 的初级工程师与知道哪些 API 永远不应该互相通信的高级架构师区分开来的同一种直觉。
这篇文章试图传递这种直觉。
第一原则:每个组件回答不同的问题
你已经从 Claude Code 作为 AI 智能体框架中了解了每个组件是什么。下表将它们重新框架为设计决策——每个组件回答一个根本不同的问题,正确的选择取决于你实际面临的是哪个问题:
| 组件 | 核心问题 | 触发方式 | 确定性 | 上下文 |
|---|---|---|---|---|
| 内存(CLAUDE.md) | 智能体始终需要知道什么? | 始终加载 | 100% | 共享、持久 |
| 命令 | 每次必须以完全相同的方式发生什么? | 用户显式(/cmd) | 100% | 无状态 |
| 技能 | 智能体应该如何处理这类问题? | 语义(Claude 决定) | 概率性 | 与主体共享 |
| 子智能体 | 谁应该做这项工作,独立地? | Claude 或用户决定 | 可配置 | 独立 |
| Hooks | 每次操作前后必须检查什么? | 事件驱动(自动) | 100% | 正交 |
| MCP | 智能体如何触及外部世界? | 工具调用 | 100% | 透传 |
当你面对设计问题时,你的第一步不是选择组件。你的第一步是识别你真正在回答哪个问题。组件从问题中自然而来。
示例: "我们需要 Claude 遵循我们的 REST API 命名规范。"
- 这是它应该始终知道的吗?→ 推送到
CLAUDE.md(内存)。 - 这是按需触发的专业工作流吗?→ 构建一个技能。
- 这是每次文件编辑前必须运行的检查吗?→ 作为 Hook 连接。
三者都有效。正确答案取决于频率、范围和失败成本:
- 如果这个项目中的每项任务都涉及 API 工作 → 内存(推送,始终存在)。
- 如果只有 20% 的任务涉及 API 设计,但涉及时 Claude 需要深入的标准知识 → 技能(拉取,按需)。
- 如果命名违规会破坏生产环境,必须机械性地捕获 → Hook(守卫,确定性)。
真正的答案通常是组合:内存中的规范、详细的设计审查技能,以及命名验证 Hook。系统性思维者设计所有三层,并理解每层为何存在。
第二原则:将知识、行为和治理分开
大多数架构混乱来自于混淆了三件应该清晰分离的事情:
知识 = 智能体知道什么(内存 + 技能参考文件) 行为 = 智能体做什么(命令 + 技能 + 子智能体) 治理 = 智能体绝对不能做什么,或必须始终检查什么(Hooks + allowed-tools + 权限)
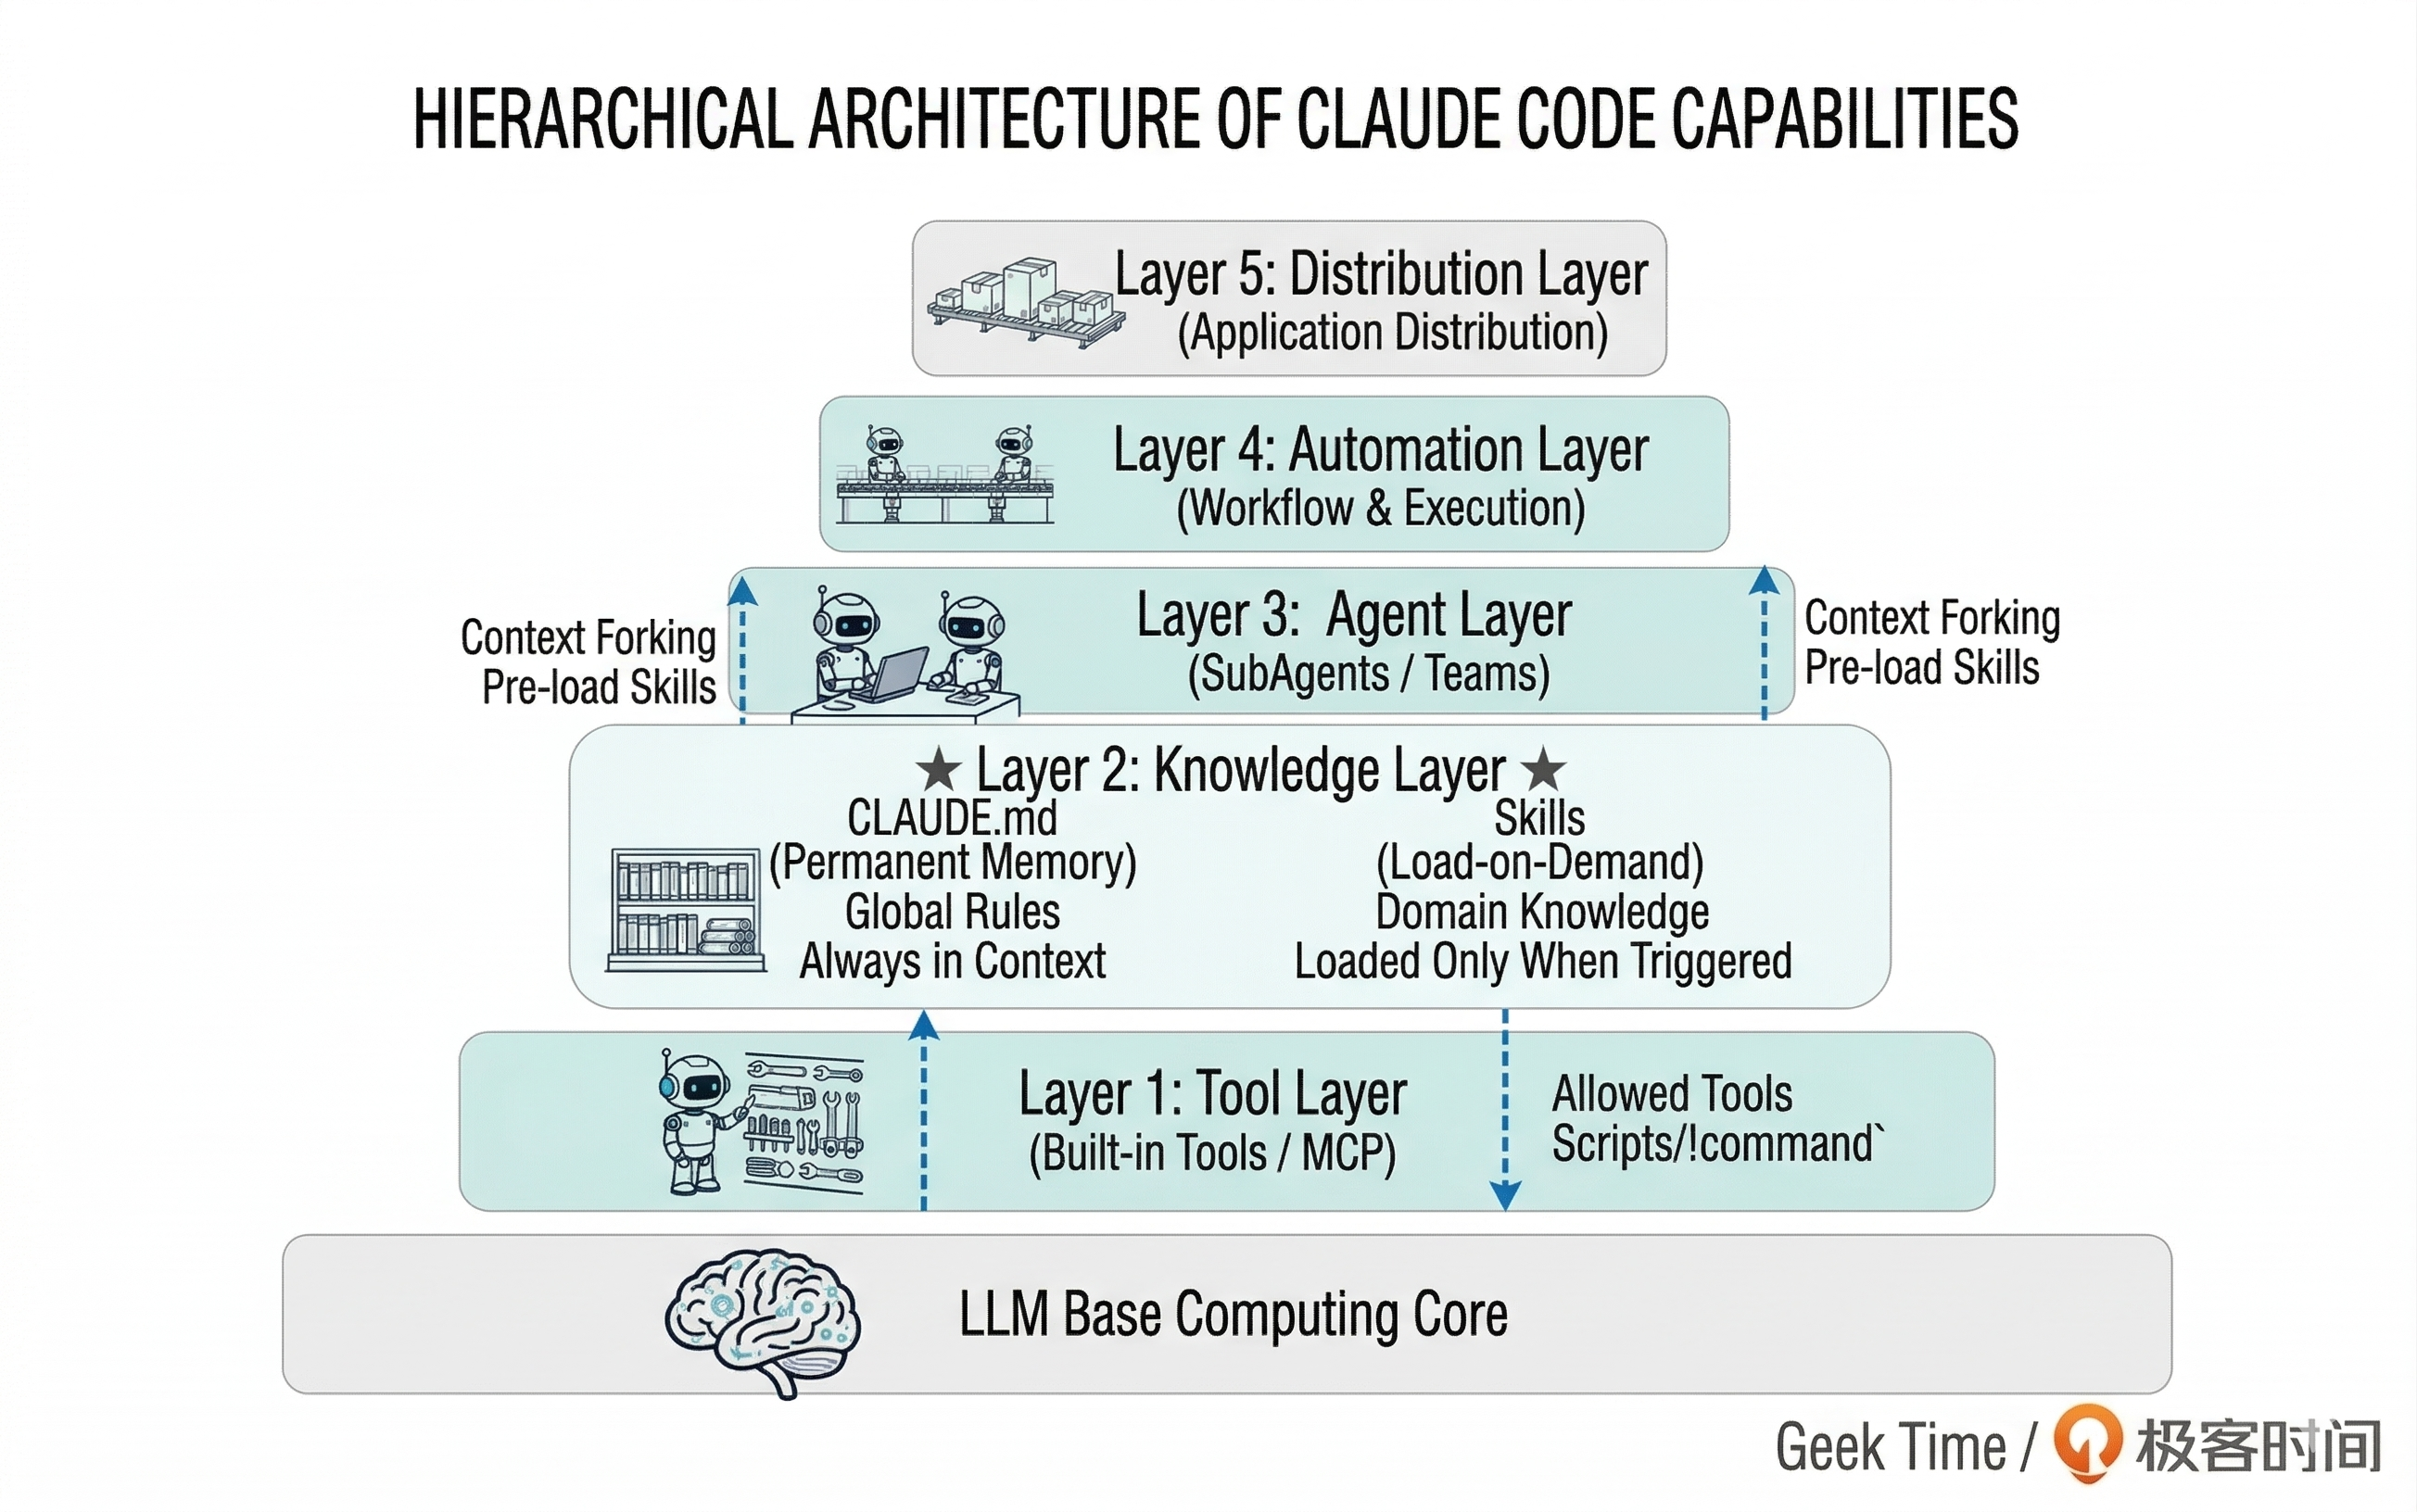
当这三个关注点被混合——当你的 CLAUDE.md 包含行为工作流,或你的技能试图执行治理规则,或你的 Hook 包含业务逻辑——系统就会变得脆弱、难以调试且无法独立演化。
清晰的分离看起来是这样的:
知识层:
  CLAUDE.md          → 通用项目上下文(始终加载)
  SKILL.md           → 领域专业知识(按需加载)
  reference/         → 深度参考材料(由 SKILL.md 加载)

行为层:
  命令               → 确定性的用户触发工作流
  技能(工作流)     → 自适应的、情境敏感的执行
  子智能体           → 隔离的任务委托

治理层:
  Hooks              → 操作前后检查、审计日志
  allowed-tools      → 每个技能/子智能体的能力边界
  权限               → 哪些技能 Claude 可以/不可以调用
当你能清晰地将系统中的每一块分配到这三类之一时,你拥有了一个可维护的架构。当你不能——当单个 SKILL.md 文件同时定义知识、执行工作流并且执行安全约束——你拥有的是等待复利的技术债务。
第三原则:推送与拉取是资源分配决策
最重要的架构决策之一是哪些知识要推送(始终存在于上下文中)与哪些要拉取(按需加载)。这不是风格偏好——这是一个具有可衡量权衡的资源分配问题。
Vercel 2026 年 2 月的实验使这一点具体化:AGENTS.md(推送)在构建/lint/测试任务上实现了 100% 通过率。技能(拉取)得分 79%——因为 Claude 有 56% 的时间没能调用技能。但这并不意味着"始终推送"。如果你将 200KB 的安全审计清单推送到每个请求中,你就在 80% 以上安全无关的交互中浪费 token,并稀释了对真正重要任务的注意力。
决策框架:
| 标准 | 推送(CLAUDE.md / AGENTS.md) | 拉取(技能) |
|---|---|---|
| 使用频率 | 超过 50% 的请求 | 低于 20% 的请求 |
| 大小 | 小(压缩后 <8KB) | 大(通过渐进式披露无限制) |
| 缺失时的失败成本 | 高(构建失败、错误规范) | 中(次优但可恢复) |
| 所需触发可靠性 | 必须始终适用 | 偶尔错过是可接受的 |
反模式:
- 推送所有内容 → 上下文膨胀、注意力稀释、token 浪费。
- 拉取所有内容 → 触发不可靠、遗漏关键上下文。
- 不明确决策 → 随意积累,逐渐降低两者效果。
系统性思维者每季度审计其知识放置:内存中有什么应该变成技能?技能中有什么已经变得足够频繁,属于内存了?
第四原则:上下文隔离是多智能体的核心价值
多智能体架构中最常见的错误是将并行性视为主要动机。它不是。上下文隔离是主要价值。 并行性是有时附带的次要收益。
Anthropic 自己的多智能体研究系统清楚地说明了这一点。该系统与单智能体设置相比实现了 90.2% 的性能提升——不主要是因为子智能体并行运行,而是因为每个子智能体都以干净、专注的上下文窗口运行。LeadResearcher 不必同时处理来自多个领域的数千条搜索结果。每个子智能体独立过滤和压缩其领域,只返回提炼过的洞察。
实践含义:不要因为想要速度而使用子智能体。要因为需要干净的上下文而使用它们。
以下是决策树:
你的单智能体质量在下降吗?
├── 否 → 保持单智能体。如果工具增多,添加技能。
└── 是 → 为什么?
    ├── 一个提示词中有太多竞争角色
    │   → 子智能体(每个有专注的系统提示词)
    ├── 上下文窗口被之前任务的噪音填满
    │   → 子智能体(隔离上下文,仅返回结果)
    ├── 不同知识领域相互污染
    │   → 子智能体或路由器(按领域隔离)
    └── 顺序阶段需要不同的权限/行为
        → 交接(状态驱动的阶段切换)
以及必须始终跟随的成本检查:
- 多智能体系统消耗的 token 约为单智能体对话的 15 倍。
- 约 80% 的性能方差由 token 量解释。
- 升级模型通常比增加更多智能体有更好的投资回报。
- 如果每个智能体无论如何都需要完整的共享上下文,多智能体增加了成本而没有增加隔离价值。
第五原则:技能和子智能体是正交的,而非替代
一个持续存在的混淆:"我应该使用技能还是子智能体?"这是一个范畴错误。技能和子智能体回答不同的问题,并以可预测的方式组合。
技能 = 如何做(方法论、标准、工具约束、质量标准) 子智能体 = 谁做(角色身份、任务范围、输出格式、上下文边界)
它们以三种典型模式组合:
模式 A:子智能体加载技能(专家工作者)
子智能体是角色。技能是其培训。一个 security-auditor 子智能体预加载 security-review 技能,成为一个独立运行的领域专家,拥有自己的上下文,将团队的安全方法论应用于它所指向的任何代码。
子智能体定义(.claude/agents/security-auditor.md):
  - 角色:安全审计专家
  - skills: [security-review]
  - 输出:结构化漏洞报告

技能定义(.claude/skills/security-review/SKILL.md):
  - 工作流:评估 → 优先级 → 深入 → 报告
  - allowed-tools: Read, Grep, Glob(只读)
  - templates/: vulnerability-report.md
  - scripts/: dependency-check.py
何时使用: 你需要一个可复用的领域专家。多个子智能体可以共享同一个技能。子智能体提供角色边界;技能提供方法论。
模式 B:技能 Fork 子智能体(隔离执行)
技能定义任务。context: fork 生成一个子智能体在隔离中执行它。主对话保持干净。
yaml
# .claude/skills/code-health-check/SKILL.md
---
name: code-health-check
context: fork
agent: Explore
allowed-tools: Read, Grep, Glob, Bash
---
Scan the entire codebase for: dead code, circular dependencies,
files exceeding 500 lines. Output a structured health report.
何时使用: 会污染主上下文的繁重扫描或分析任务。技能包含方法论;fork 提供隔离。
模式 C:流水线编排(多阶段装配线)
多个子智能体按顺序执行,每个预加载不同的技能。清晰的接口契约定义每个阶段生成什么以及下一个阶段消费什么。
阶段 1:route-scanner(技能:route-scanning)→ 输出 routes.json
阶段 2:doc-writer   (技能:doc-writing)    → 消费 routes.json,输出 docs/
阶段 3:qa-checker   (技能:quality-checking)→ 消费 docs/,输出 qa-report.md
何时使用: 多阶段工作流,其中每个阶段需要不同的专业知识、不同的工具访问,并产生被下一阶段消费的定义良好的制品。
决策启发式: 问"这个任务需要一个有自己上下文的独立身份吗?"如果是 → 子智能体。如果不是 → 主智能体上的技能。然后问"这个子智能体需要结构化的专业知识吗?"如果是 → 预加载技能。这两个决策是独立的。
第六原则:治理不是事后考虑
在我见过的每一个失败的生产系统中,根本原因不是能力不足——而是治理不足。智能体能做太多,检查太少,什么都没记录。
Hooks 是治理层,但治理比 Hooks 更广泛。它是一个三层设计:
第一层:能力边界(allowed-tools) 每个技能和子智能体应该有一个最小工具白名单。审查技能获得 Read、Grep、Glob——没有 Write,没有 Edit,没有 Bash。文档技能获得 Write 但不是 Edit(它创建新文件,从不修改现有文件)。这不是权限管理,而是知识约束行动——技能"知道"它做什么样的工作,并执行相应的能力边界。
第二层:过程门控(Hooks) 预编辑 Hooks 验证提议的更改。后写 Hooks 运行 linter。预 bash Hooks 检查危险命令。这些自动触发,每次都触发,无论哪个技能或子智能体发起了操作。它们与业务逻辑正交——它们不关心 Claude 想做什么,只关心是否安全。
第三层:审计追踪(Hooks + 通过 MCP 的外部系统) 每个重要操作——文件编辑、工具调用、子智能体派遣——都应该被记录。在生产系统中,这会传入可观测性仪表板,随时间追踪智能体决策模式。Anthropic 工程团队强调这是必不可少的:智能体系统中的微小变化会级联为大的行为变化,调试需要理解不仅仅是结果,还有决策路径。
系统性思维者在编写第一个技能之前设计所有三层。在实践中:
对于你添加的任何新能力:
1. 它需要什么工具?(最小白名单)
2. 它行动前后应该检查什么?(Hook)
3. 你如何知道它做了什么以及为什么?(审计)
整合起来:一个完整的示例
需求: "构建一个自动代码审查流水线,在每个 PR 上运行,检查安全问题,验证测试覆盖率,并将结果发布到 Jira。"
系统性分解:
第一步:识别问题
| 子问题 | 问题类型 | 组件 |
|---|---|---|
| PR 被打开,流水线必须触发 | "什么必须自动发生?" | 无头模式(CI/CD)+ Hook |
| 安全审查需要深度分析 | "如何发现安全问题?" | 技能(security-review) |
| 测试覆盖率检查是确定性的 | "什么必须每次以完全相同的方式发生?" | 技能内的脚本,或命令 |
| 安全和测试是独立领域 | "谁应该做每项工作,独立地?" | 子智能体(独立上下文) |
| 结果必须发布到 Jira | "智能体如何触及外部世界?" | MCP |
| 没有编辑应该引入新漏洞 | "每次操作前必须检查什么?" | Hook(预编辑) |
第二步:设计拓扑
CI/CD 触发(无头模式)
  → 监督智能体
    ├── 子智能体:security-auditor
    │   └── 技能:security-review(只读工具)
    ├── 子智能体:test-verifier
    │   └── 技能:coverage-check(Bash 用于测试运行器)
    └── 两者完成后:
        → 监督者综合结果
        → Hook:audit-log(记录决策追踪)
        → MCP:jira-connector(发布结构化报告)
第三步:定义契约
security-auditor输出:{ vulnerabilities: [...], severity: string, recommendation: string }test-verifier输出:{ coverage_percent: number, uncovered_files: [...], new_tests_needed: boolean }- 监督者消费两者,生成 Jira 格式的报告
- 预编辑 Hook:阻止任何触碰
src/auth/的文件修改,除非有 security-auditor 批准
第四步:应用治理清单
security-auditorallowed-tools:Read, Grep, Glob(只读——审计者不修复)test-verifierallowed-tools:Read, Bash(可以运行测试,不能编辑代码)- 监督者 allowed-tools:完整集合(它综合并可能格式化输出)
- Hooks:预编辑安全检查,完成后审计日志
- 所有子智能体输出在外部发布前由监督者验证
第五步:检查成本/收益
- 两个子智能体 + 监督者 = 约 3 倍单智能体做所有事情的 token 成本。
- 但上下文隔离防止安全分析被测试输出污染(反之亦然)。
- 如果此流水线在每个 PR 上运行(高频率、高价值),成本是合理的。
- 如果每月运行一次,带技能的单智能体可能就足够了。
架构决策矩阵
面对任何新需求时,通过此矩阵运行:
| 场景 | 推荐模式 | 原因 |
|---|---|---|
| 单领域,<5 个工具,上下文 <50K token | 单智能体 + 工具 | 尽可能简单,无协调开销。 |
| 单领域,>10 个工具,提示词膨胀 | 单智能体 + 技能 | 渐进式披露减少提示词重量。 |
| 多领域,每个需要干净上下文 | 子智能体 | 隔离防止跨领域污染。 |
| 具有角色转换的顺序多阶段过程 | 交接 | 阶段纪律确保推进前的完整性。 |
| 跨多个数据源的并行查询 | 路由器 | 最大并行性,每个分支隔离。 |
| 具有不同阶段和制品的复杂流水线 | 流水线(子智能体 + 技能) | 阶段间清晰契约;独立维护。 |
| 必须可移植的团队最佳实践 | 插件(捆绑命令 + 技能 + 子智能体 + Hooks) | 安装一次,继承整个工程文化。 |
更宏观的视角:这个思维框架适用于什么
本文中的六个原则——问题优先的组件选择、知识/行为/治理分离、推送与拉取的资源分配、以隔离为主要价值、正交组合、治理优先设计——并非 Claude Code 特有的。
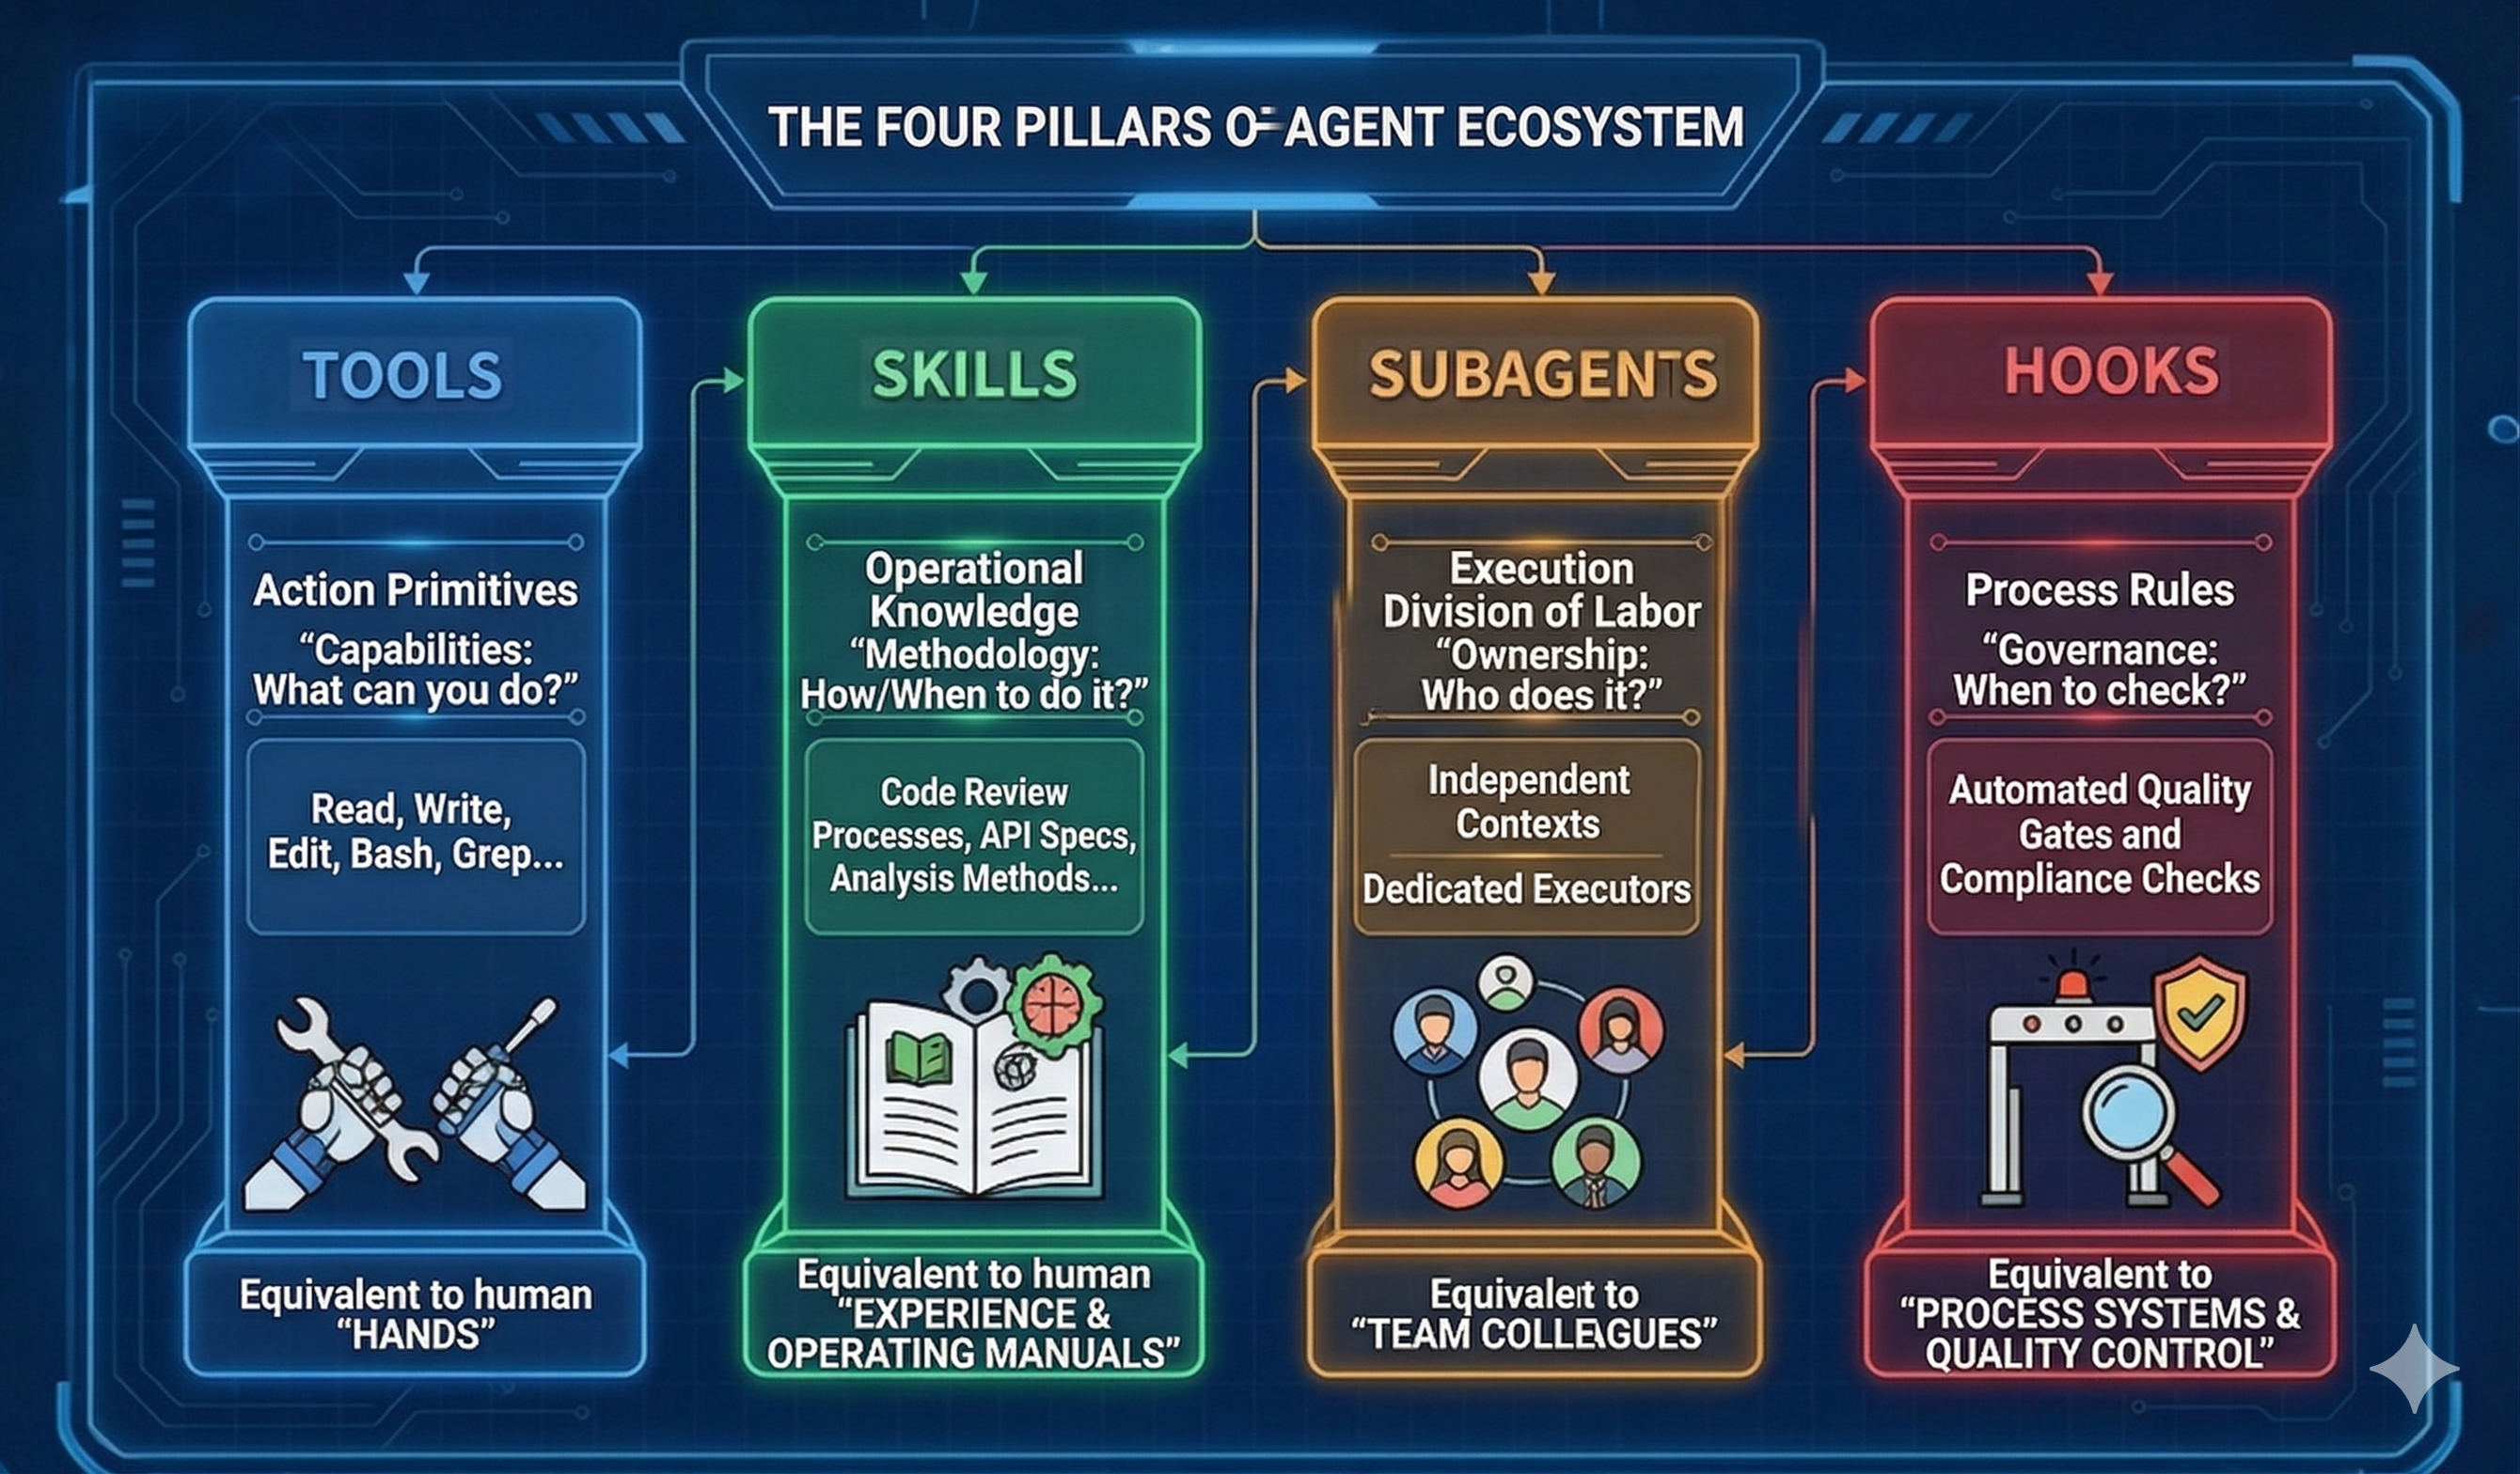
这些是治理微服务架构(有界上下文、API 契约、断路器)、组织设计(角色清晰度、信息流、问责制)和系统工程(关注点分离、纵深防御、可观测性)的相同原则。
当开源项目 OpenClaw(Clawdbot)在社区讨论中出现时,有经验的工程师能立即评估其设计权衡——不是因为他们读过源代码,而是因为他们认出了架构模式。它优先考虑任务分解、执行隔离和结果收集,而非花哨的多智能体编排。这种克制就是架构。它反映了同一原则:最好的架构是能消化复杂性的最简单架构。
评估任何 AI 智能体系统时,同样的思维适用:
- 它解决的核心工程问题是什么?(如果你无法用一句话回答,这个系统可能过度工程化了。)
- 它是在用上下文换智能,还是用架构换可控性?(前者有效直到失效为止,后者可扩展。)
- 治理边界在哪里?(如果没有,这是演示,不是系统。)
这也是为什么技能在不到 100 天内从 Claude Code 逃脱成为行业标准。到 2026 年 2 月,超过 27 个智能体平台原生支持技能,注册超过 52000 个,顶级技能超过 18 万次安装。技能赢得了,因为它们是声明式的(纯 Markdown,无运行时)、自包含的(复制目录,完成)以及以知识为中心的(价值是专业知识,不是格式)。由 Anthropic、OpenAI 和 Block 在 Linux 基金会下共同创立、拥有 97+ 成员的 Agentic AI Foundation(AAIF)正式化了这个生态系统:MCP 用于工具接口,AGENTS.md 用于项目规范,goose 用于执行,技能作为将它们绑定在一起的知识层。
更广泛的教训是:在 2026 年,AI 工程的竞争优势不是模型选择,而是知识工程——将领域专业知识分解为可组合、可治理、可移植的单元,并以系统性思维将它们组合起来的能力。
五条黄金法则(重新框架为思维启发式)
从简单开始,赚取复杂性。 每个额外的组件必须针对具体的瓶颈为自己辩护。如果你说不出瓶颈是什么,你不需要这个组件。
工具先于智能体,技能先于子智能体。 最小、最便宜的能力扩展单元优先。只有在更简单的机制被证明不足时才升级。
为了清晰而隔离,而非为了速度。 上下文隔离是关于防止污染,而非关于并行性。如果你需要速度但不需要隔离,在单一智能体内批处理。
在构建之前治理。 在定义智能体能做什么之前,先定义它不能做什么。
allowed-tools白名单和预操作 Hooks 应该是你设计中的第一批制品,而不是最后的。为维护者设计,而非为演示。 一个在演示中令人印象深刻但六个月后不同工程师无法调试、审计或修改的系统不是架构,而是行为艺术。
参考文献
- Anthropic Engineering: How We Built Our Multi-Agent Research System
- LangChain: How and When to Build Multi-Agent Systems
- Claude Code Docs: Extend Claude with Skills
- Anthropic API Docs: Agent Skills Overview
- Anthropic: Skills Explained
- Linux Foundation: Formation of the Agentic AI Foundation
- The Decoder: Vercel Push vs. Pull Experiment
- Towards Data Science: Claude Skills and Subagents — Escaping the Prompt Engineering Hamster Wheel
- VS Code Blog: Multi-Agent Development (Feb 2026)