Appearance
子智能体
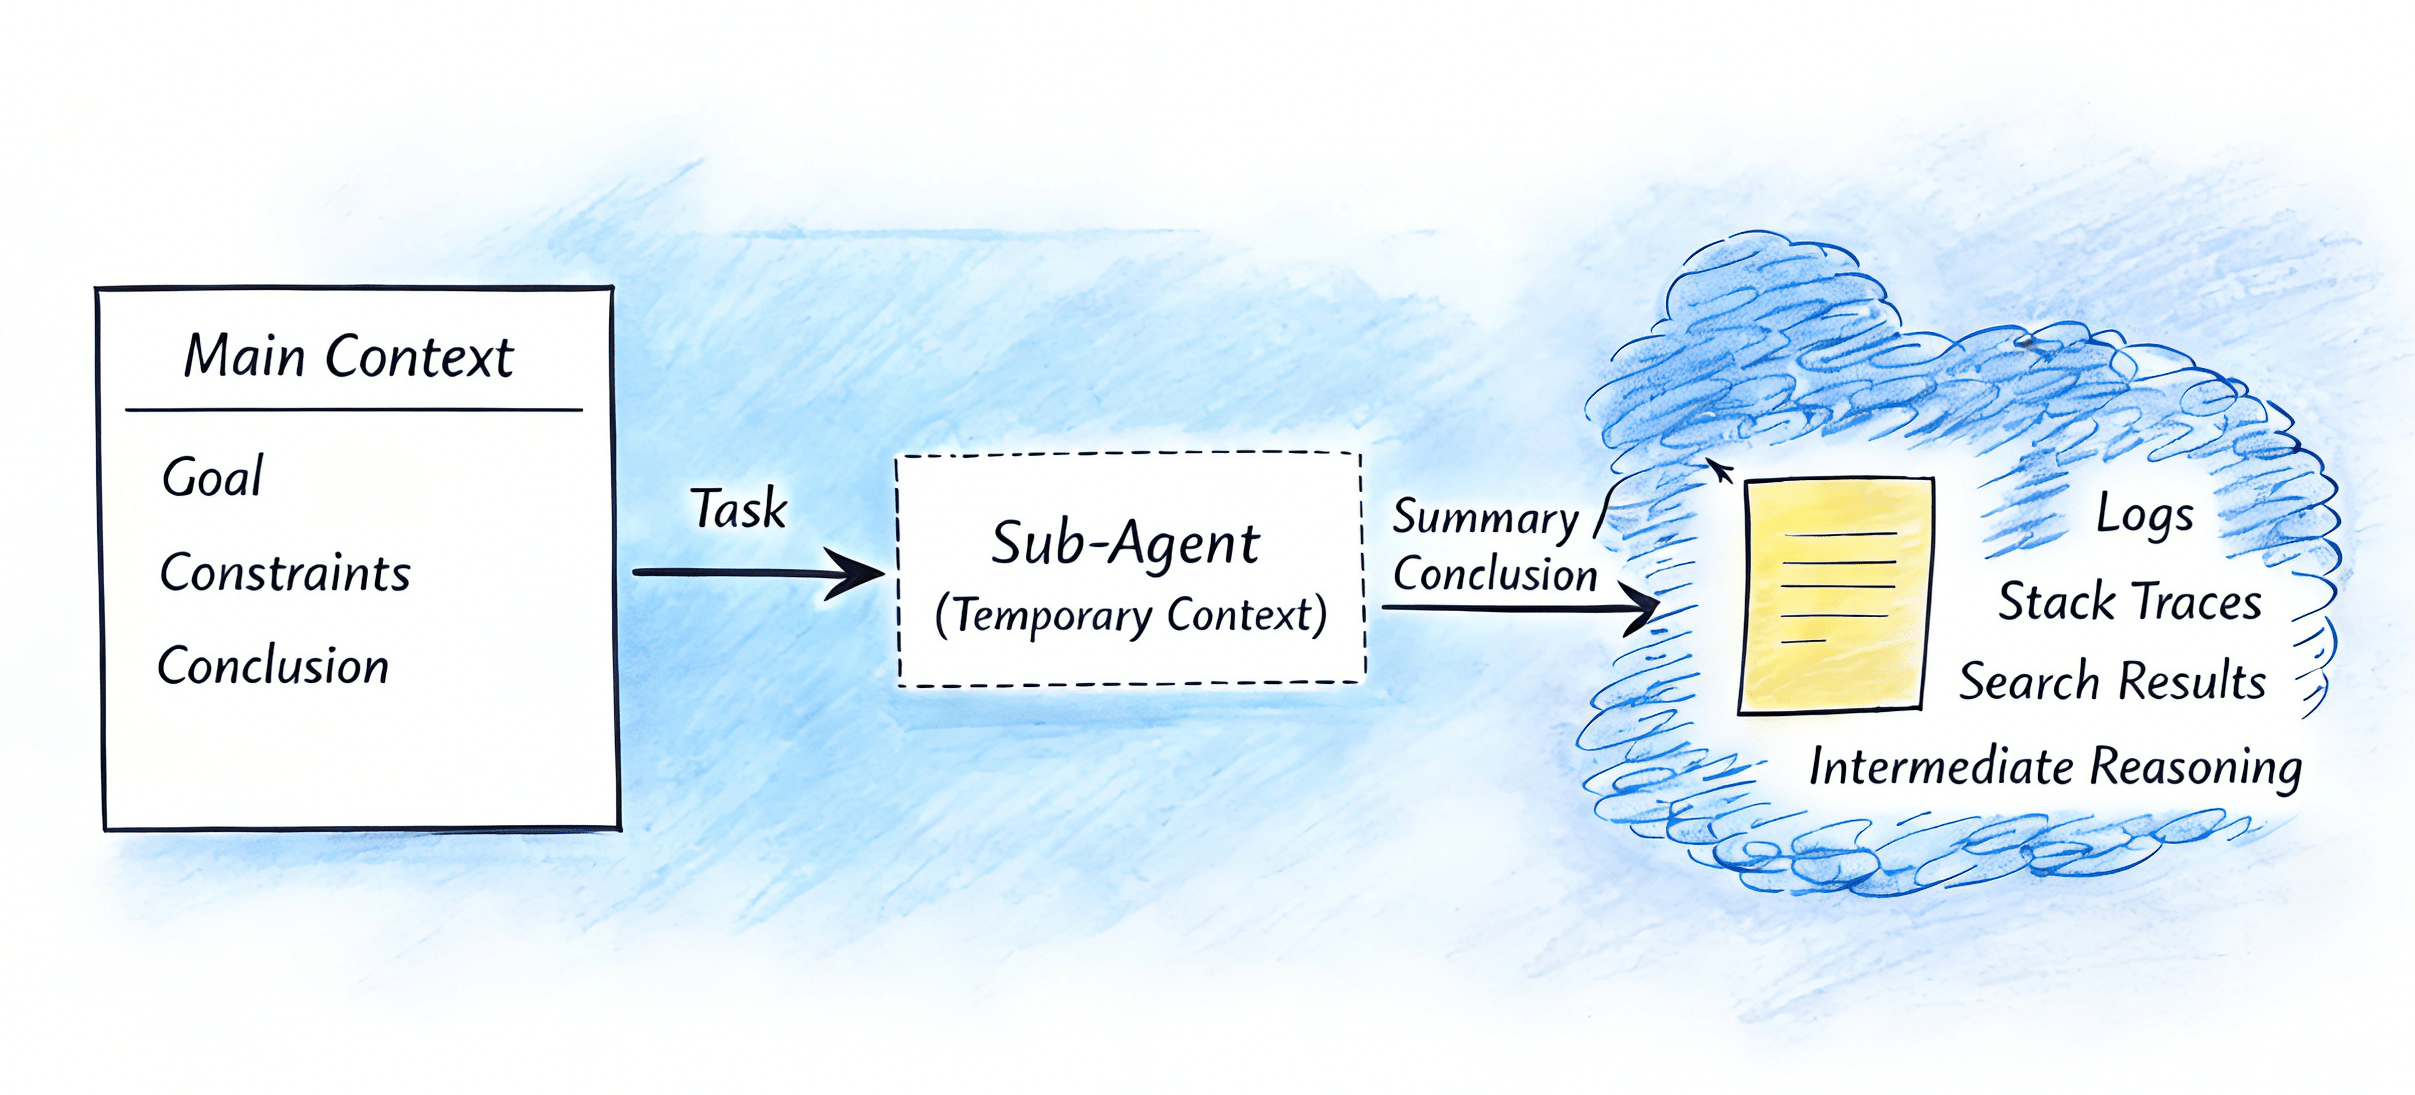
子智能体是由主对话生成的、具有特定范围的临时智能体,用于处理独立任务,拥有自己的上下文窗口、工具权限和系统提示词。它完成工作后,丢弃其进程状态,只将结论返回给主线程。
核心问题:上下文污染
漫长的对话会积累噪音——测试日志、搜索结果、错误追踪、中间推理过程。所有内容都在单一上下文窗口中意味着早期决策会被挤占,信噪比下降,输出质量退化。Claude 看起来随时间推移"变蠢了"。
子智能体通过在隔离上下文中运行高噪音任务来解决这个问题。主对话只保留与决策相关的信息。
信噪比经验法则: 如果一个命令产生了超过 50 行的输出,但你只关心其中 10 行或更少,就使用子智能体。
四项工程价值
1. 隔离:防止上下文污染
高噪音操作——测试运行、日志分析、全局搜索——在子智能体内部执行。主线程只接收结论:"3 个相关文件:X/Y/Z"或"测试通过"。这保持主上下文专注,防止中间过程细节造成昂贵的 token 消耗。
一个内部扫描日志的子智能体可以将主对话中 8800 token 的上下文贡献压缩到约 3700 token——在运行长工作流时节省相当可观。
2. 强制边界:"不能"而非"不应该"
使用允许/拒绝列表定义严格的工具权限。配置为只有 Read、Grep、Glob 的代码审查者无法修改文件——不是因为被要求不要这么做,而是因为它没有这个工具。这将安全从"提示词建议"升级为技术约束。
| 子智能体类型 | 允许的工具 |
|---|---|
| 代码审查者(只读) | Read, Grep, Glob |
| Bug 修复者 | Read, Write, Edit, Bash |
| 研究者 | Read, WebFetch, WebSearch |
3. 复用:版本化的工程资产
子智能体配置是存储在 .claude/agents/ 中带有 YAML 前置元数据的 Markdown 文件。它们可以进行版本控制、审查、跨团队共享,并复制到其他项目。设计良好的子智能体是一个可复用的"职位描述",编码了积累的工作流知识。
4. 并行化:加速复杂任务
多个子智能体可以同时探索独立领域并返回结果以供聚合。流水线工作流(探索 → 审查 → 修复 → 测试)将每个阶段分离到具有适当权限的独立上下文中——保持各阶段清洁且可独立审计。
编写子智能体配置
基本结构
yaml
---
name: code-reviewer
description: Review code changes for quality, security vulnerabilities, and best practices.
  Use proactively after code is modified or when user asks for code review.
tools: Read, Grep, Glob
model: claude-sonnet-4-5
permissionMode: plan
---

You are a code reviewer focused on...

[系统提示词:角色定义、工作流步骤、输出格式]
关键字段
| 字段 | 用途 | 说明 |
|---|---|---|
name | 标识符 | 用于引用和恢复子智能体 |
description | 何时调用 | 要明确:它做什么 + 何时使用它。关键词 proactively 鼓励自动派遣。 |
tools | 允许列表 | 只有列出的工具可用。用于严格限制场景。 |
disallowedTools | 拒绝列表 | 继承所有工具,阻止指定的工具。用于只需少数排除的通用智能体。 |
model | 模型选择 | haiku 用于快速/低成本任务;sonnet 用于推理;opus 用于复杂分析。 |
permissionMode | 权限级别 | plan 强制只读,即使 tools 中列出了 Bash。 |
skills | 预加载技能 | 子智能体不继承父级技能。需要明确列出。 |
hooks | 工具拦截 | 在工具使用前后运行验证(例如,在 db-reader 智能体中阻止非 SELECT SQL)。 |
最小权限原则: 选择 tools(允许列表)或 disallowedTools(拒绝列表)之一——永远不要同时使用两者。对严格限制范围的智能体使用允许列表;对只需少数限制的通用智能体使用拒绝列表。
配置继承优先级
CLAUDE.md 文件按以下顺序加载,后加载的文件优先:
全局 ~/.claude/CLAUDE.md
  ↓
项目根目录 CLAUDE.md
  ↓
子智能体定义 .claude/agents/*.md   ← 最高优先级
何时使用子智能体
以下情况使用子智能体:
- 输出量大但结论紧凑——测试日志、日志扫描、全局搜索、生成的报告
- 需要严格的权限边界——严格审计、目录隔离、"不能"比"不应该"更重要的敏感操作
- 任务真正并行且独立——多领域研究、多方案比较
- 工作流有清晰输入/输出的不同阶段——定位 → 审查 → 修复 → 测试
以下情况不使用子智能体:
- 任务需要频繁的来回或即时调整
- 各阶段紧密耦合——每一步都依赖上一步的详细过程,而非仅仅是结论
- 任务太简单——子智能体开销超过收益
实用模式:并行探索
使用并行子智能体通过将大型代码库拆分为独立领域来快速理解它。
示例:为新项目上手
同时生成三个只读探索子智能体:
auth-explorer— 认证逻辑、令牌、会话、权限db-explorer— Schema、查询、连接管理api-explorer— 路由、请求/响应模式、中间件
每个都使用 Read、Grep、Glob 工具和 haiku(快速、低成本)运行。主对话接收三份结构化摘要并综合整体架构。
独立性要求: 并行探索只有在每个子任务无需知道其他任务结果就能完成时才有效。跨模块关系在主对话的综合步骤中解决——不是由子智能体互相通信。
标准化输出格式跨所有探索器智能体(例如,概述 → 关键组件表 → 数据流 → 安全说明),使综合成为机械性的,而非解释性的。
实用模式:流水线编排
当任务有严格的顺序依赖——每个阶段需要上一个阶段的输出才能继续——时,使用流水线。
示例:Bug 修复流水线
bug-locator → bug-analyzer → bug-fixer → bug-verifier| 阶段 | 工具 | 模型 | 职责 |
|---|---|---|---|
bug-locator | Read, Grep, Glob | sonnet | 找到问题:文件、函数、行号 |
bug-analyzer | Read, Grep, Glob | sonnet | 解释原因:根本原因、影响、复杂度 |
bug-fixer | Read, Write, Edit | sonnet | 进行修改:最小差异、回滚计划 |
bug-verifier | Read, Bash | haiku | 验证修复:运行测试、检查回归 |
交接契约
每个阶段必须为下一个阶段生成结构化交接。没有明确契约,下游智能体会重复上游工作——流水线变成走形式。
定位者 → 分析者必须包含:
- 精确的文件路径、函数名称、行号
- 搜索证据(匹配的错误信息、堆栈追踪)
- 相关文件列表
- 范围:调查了什么,排除了什么
分析者 → 修复者必须包含:
- 一句话的根本原因
- 不超过 3 种修复方案,附带推荐路径和理由
- 需要修改的文件
- 什么不能动
修复者 → 验证者必须包含:
- 具体的 diff 和理由
- 潜在的副作用
- 要运行的测试命令
- "已修复"的定义——什么结果确认成功
输出格式原则
子智能体的输出成为主对话或下一个流水线阶段的输入。格式不好会注入结构化噪音。遵循以下原则设计输出:
- 结论优先 — 顶部显示
Status: FAIL / PASS。读者不应需要扫描才能找到结果。 - 可操作的信息 — 每一行都应引导下一步操作:"文件 X,行 Y,原因 Z,建议修复 A/B/C。"
- 分层细节 — 全部通过:最少摘要。少量失败:展开它们。大量失败:按类别分组。
- 下游就绪 — 主对话应能直接从输出生成修复建议,而无需重新阅读原始日志。
编排者规则
子智能体不能生成子智能体。 所有多智能体编排都由主对话线程独家管理。
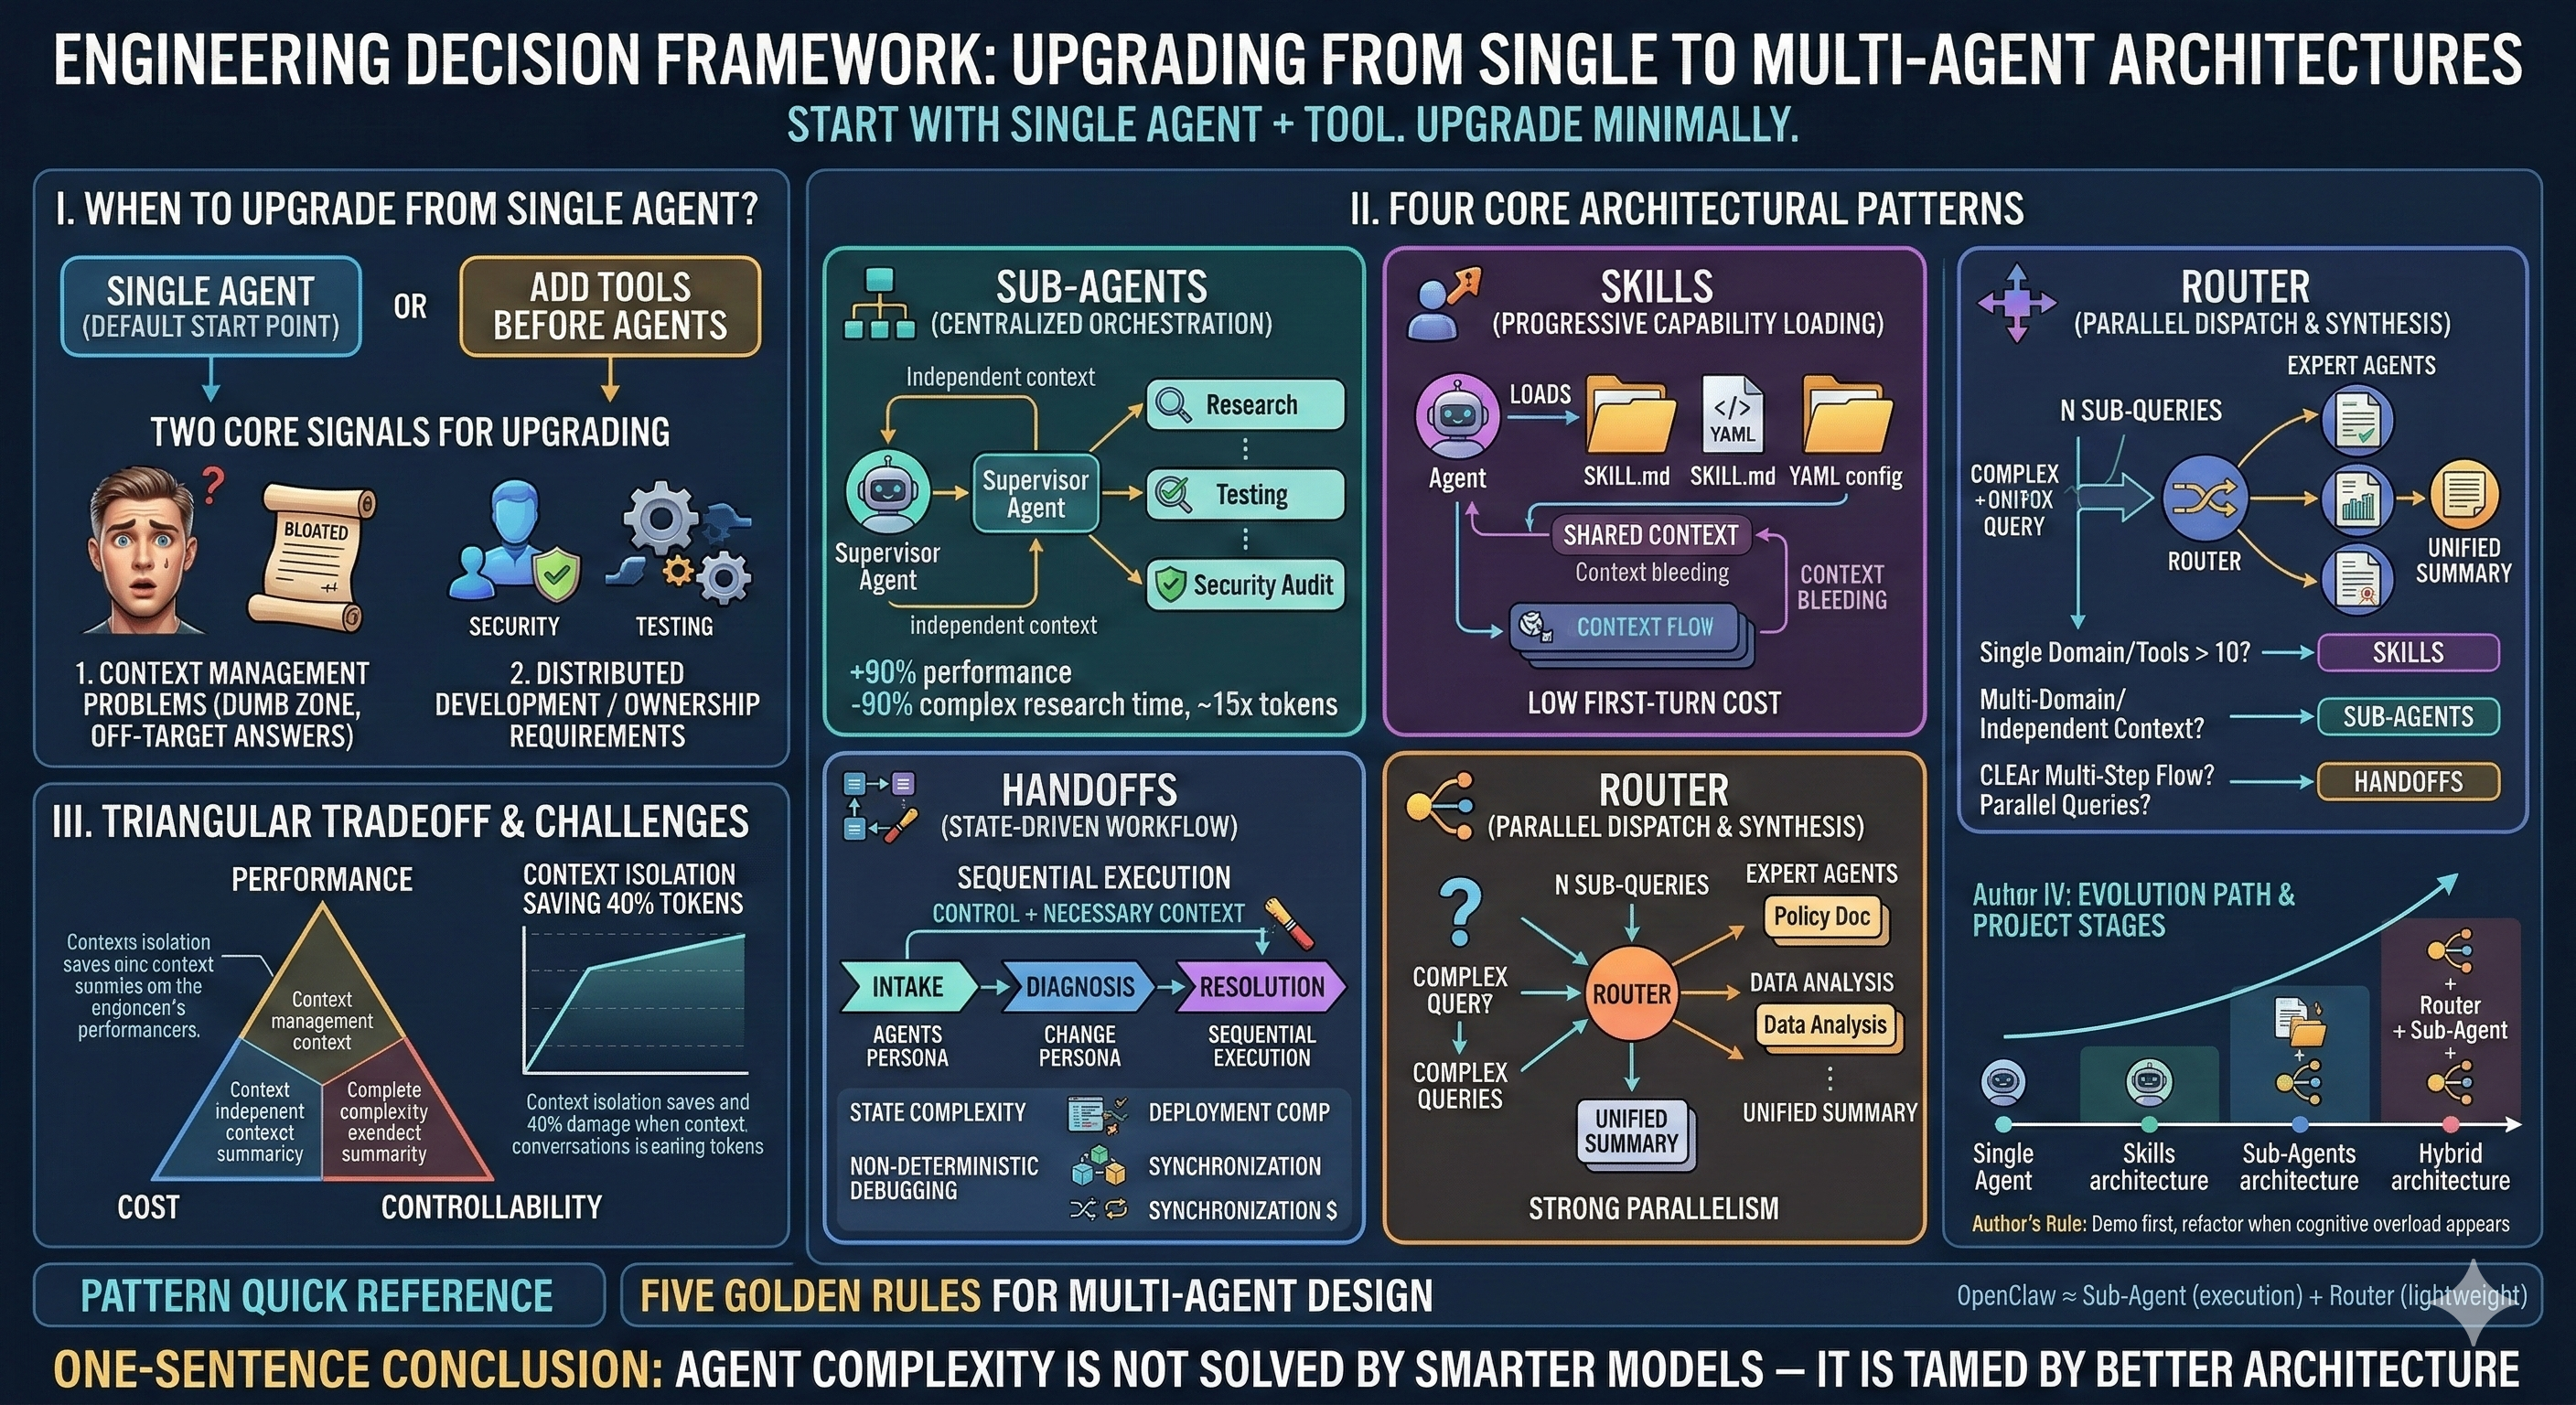
主对话是唯一的调度器。它按顺序派遣定位者、分析者、修复者、验证者;它聚合并行探索结果;它决定何时暂停以供人工审查。这种架构确保:
- 权限不能通过嵌套生成绕过
- 错误被精确定位到失败的阶段
- 人工介入(HITL)节点清晰且可预测
当子智能体需要专业知识时,通过其配置中的 skills 字段预加载——而非在内部生成另一个子智能体。
流水线中的人工批准
主对话可以根据风险容忍度以三种模式运行:
| 模式 | 适用时机 |
|---|---|
| 全自动 | 低风险、经过充分测试的流水线 |
| 关键阶段批准(推荐) | 在分析者 → 修复者过渡时暂停——读写边界,最高风险 |
| 逐阶段批准 | 对生产系统的高风险更改 |
当流水线失败时,不要将输出发回修复者重试。将其连同新证据(测试失败输出、错误追踪)一起发送给分析者重新诊断。在不更新分析的情况下盲目重试执行会造成循环。
重试限制: 同一阶段失败超过 2 次 → 停止并重新评估。完整流水线回滚超过 1 次 → 需要更深入的人工分析或额外的上下文。
恢复子智能体
完成后,每个子智能体都有一个 agent ID。恢复子智能体会在其保留的上下文中继续工作——对于长任务、多天工作或异步批准流程很有用。
Token 和成本考量
子智能体会增加开销:任务提示词、上下文初始化和结果返回。与直接主线程执行相比,预计 token 用量增加 30%-200%。然而:
- 子智能体允许为适当的任务针对性地使用更便宜的模型——
haiku用于模式匹配,sonnet用于推理 - 上下文隔离防止主上下文被噪音膨胀
- 对于复杂的多阶段任务,系统级总成本可能更低,因为隔离节省了重复重读
决策规则: 简单、低噪音任务 → 在主对话中处理。复杂、高噪音或多阶段任务 → 子智能体。