Appearance
Hooks
为 AI 辅助开发构建安全、质量与治理层
如果你曾在任何严肃的项目中使用过 Claude Code,你可能经历过某种不安。Claude 很聪明——令人印象深刻——但"聪明"和"安全"并不是同一回事。当它决定好心地重新组织你的 .env 文件会怎样?或者用一个随意的 rm -rf 来清理你的项目?或者强制推送到 main?
这正是 Hooks 的用武之地——Claude Code 用于将确定性、可执行的规则注入原本概率性 AI 工作流的机制。将它们视为 AI 工具调用的中间件:它们在 Claude 生命周期的每个关键节点拦截、观察和增强 Claude 的操作,让你不再担心 AI 可能做什么,转而开始定义它永远不应该做什么。
这篇文章从头到尾讲解 Hooks 系统:心智模型、事件架构、配置模式,以及最重要的——经过实战检验的方案,将 Claude Code 从一个聪明的助手转变为一个受治理的工程系统。
官方资源: Hooks 指南涵盖入门知识,Hooks 参考文档详细记录了每个事件 schema 和配置选项。
Hooks 存在的原因:中间件心智模型
Claude Code 的扩展系统有三大支柱,各有其独特角色:
- 命令告诉 Claude 要做什么——它们是任务入口点。
- 技能告诉 Claude 如何做——它们携带领域知识和模式。
- Hooks 定义是否允许做,以及做的前后必须发生什么——它们是护栏、格式化器、审计追踪。
关键洞见:Hooks 是唯一能拦截或修改 Claude 行为的机制。命令和技能是建议性的;Hooks 是强制执行的。它们的区别是"请记得运行 linter"(Claude 在上下文压缩后可能遗忘)与"每次保存文件都运行 linter,句号"之间的差距。
这与 Web 框架中中间件的工作方式直接对应:你的应用逻辑(Claude)处理创造性工作,而中间件(Hooks)强制执行横切关注点——认证、日志、验证、频率限制——无需应用知道或关心这些。
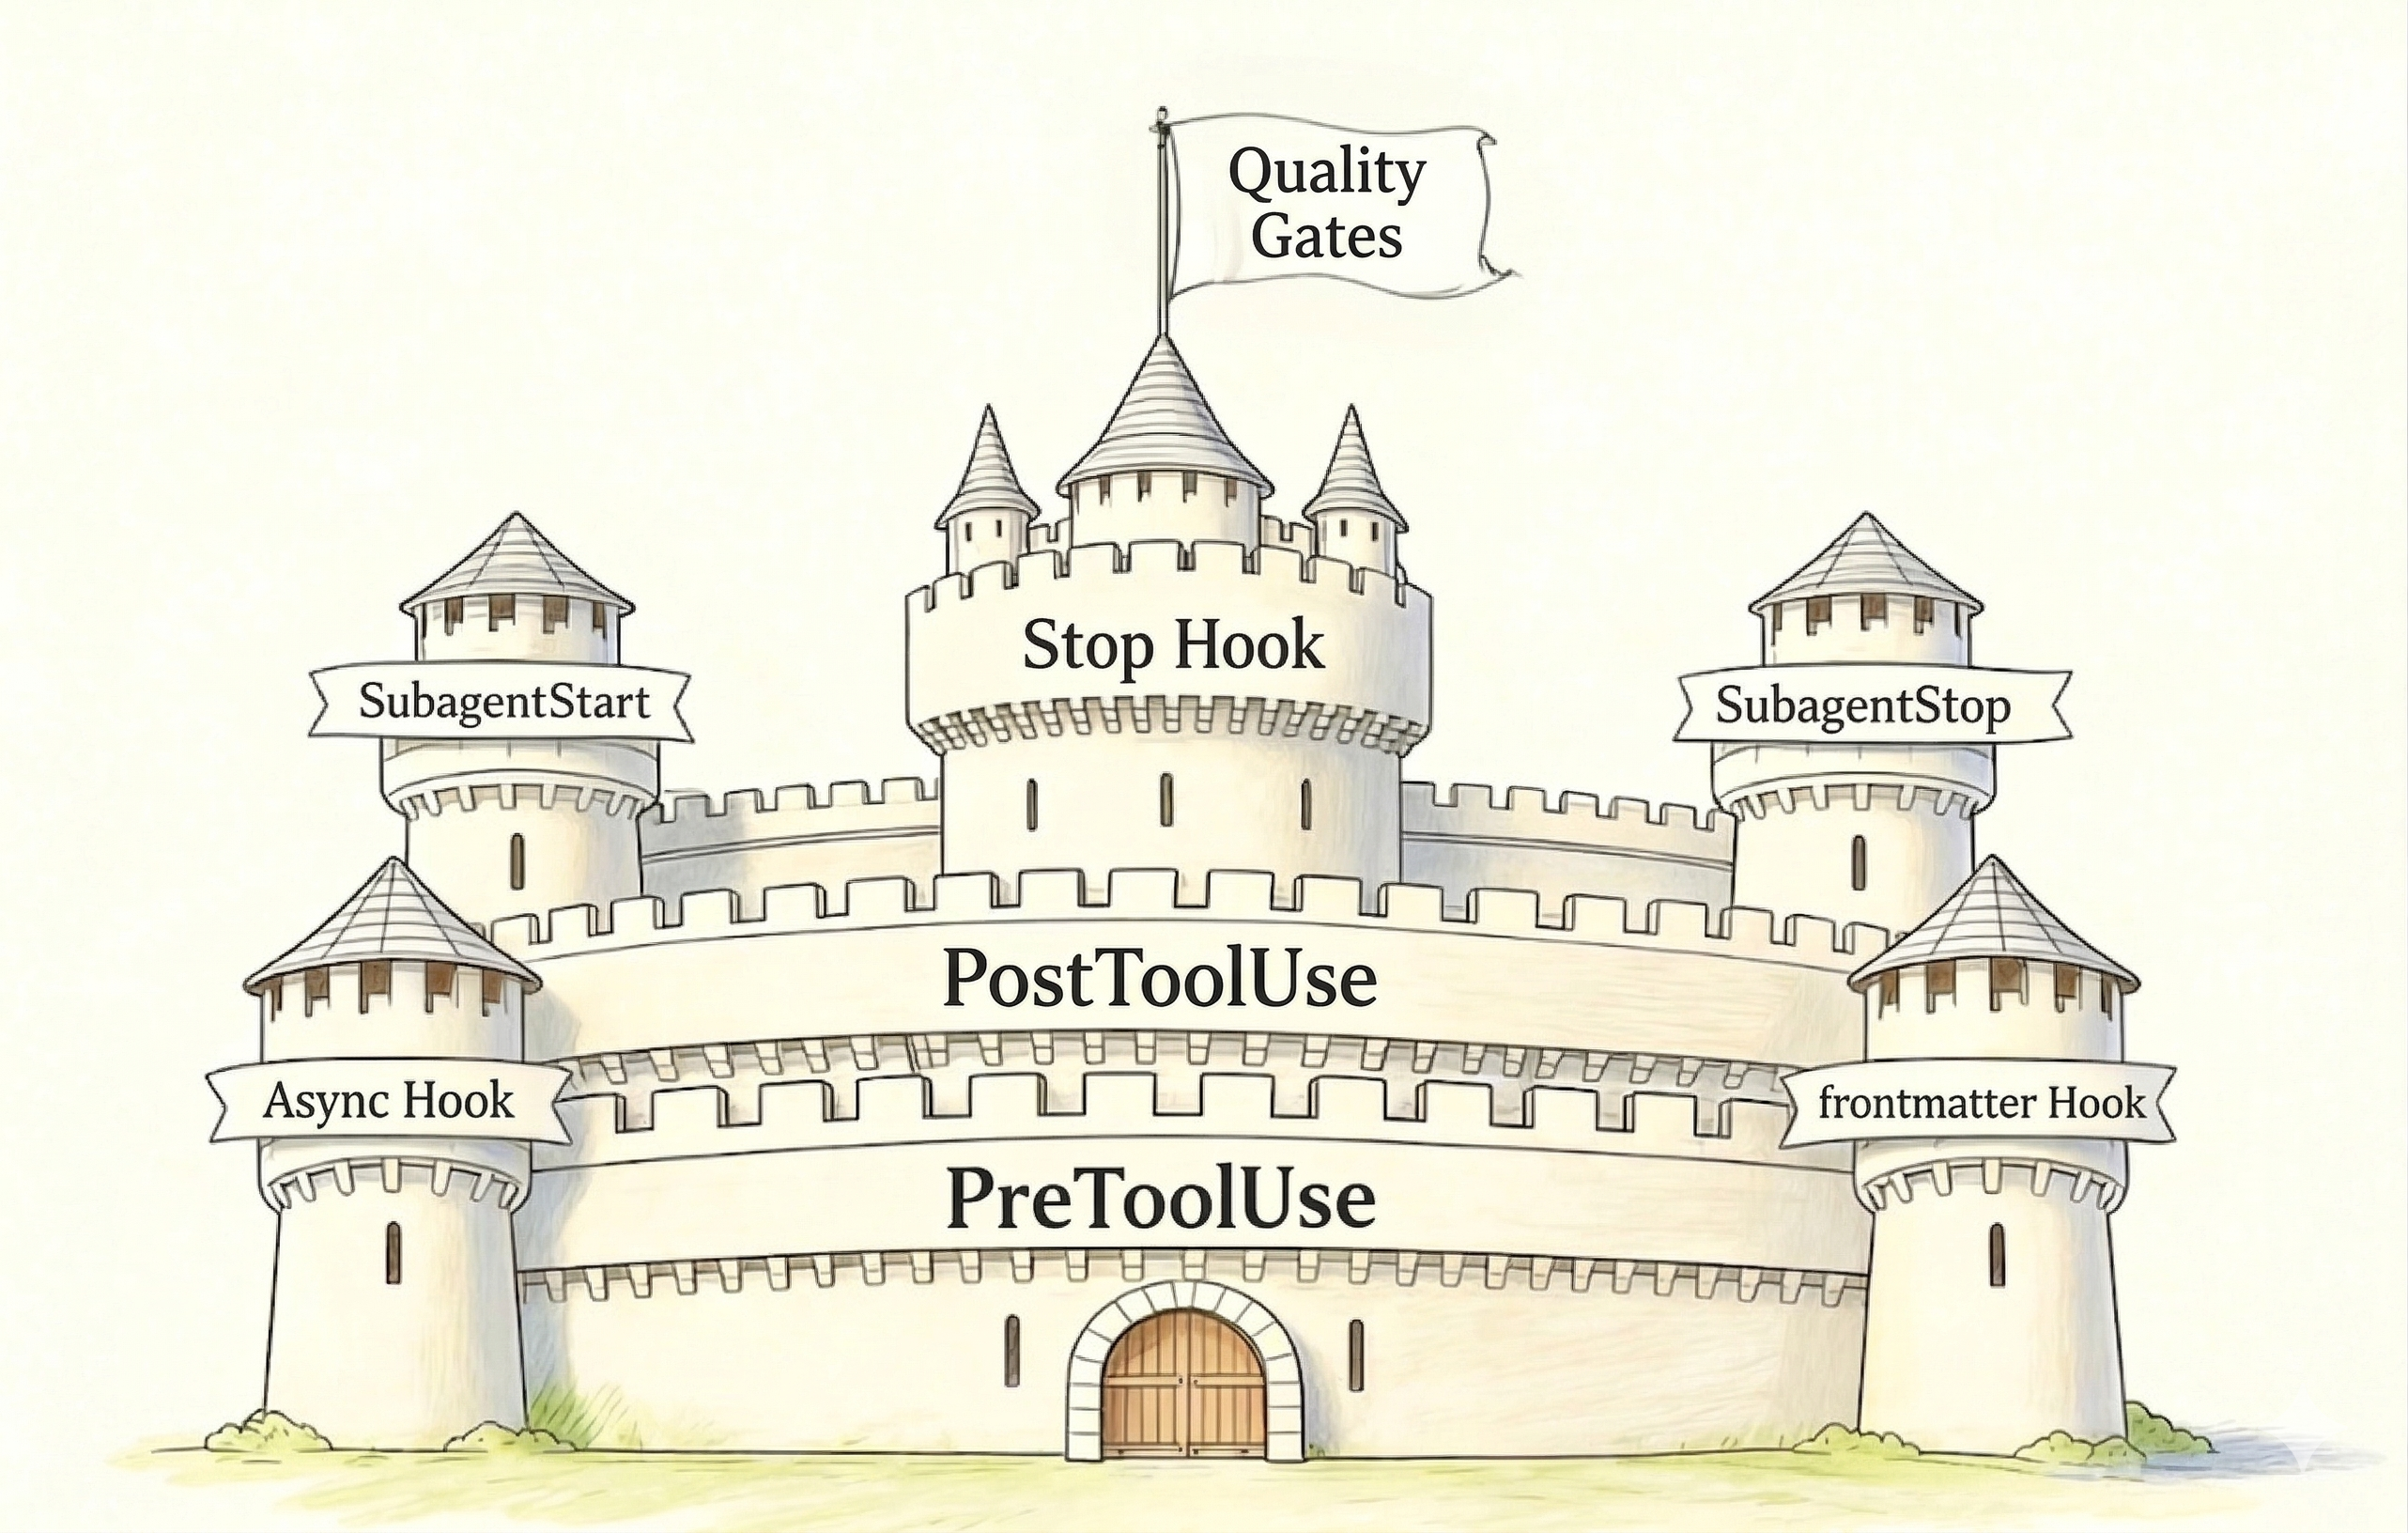
事件生命周期:Hooks 何时触发
Hooks 附加到特定的生命周期事件。这些事件根据其赋予的权力分为三类:
控制点 — 这些可以改变执行路径:
PreToolUse:在任何工具调用之前触发。可以阻止调用、修改其参数或放行。UserPromptSubmit:在 Claude 处理用户消息之前触发。可以拒绝或重写输入。Stop/SubagentStop:在 Claude(或子智能体)认为已完成时触发。可以强制其继续工作。
接管点 — 这些替换默认行为:
PermissionRequest:你的脚本自动批准或拒绝权限请求,替代交互式对话框。这是构建"自动驾驶模式"的方式。
观察点 — 这些只是监视,无法阻止:
PostToolUse、PostToolUseFailure:在工具成功或失败后触发。可以向 Claude 的上下文注入反馈。SessionStart、SessionEnd:在会话边界触发。用于环境配置和清理。SubagentStart:在子智能体启动时触发。可以注入上下文但无法阻止启动。Notification、PreCompact:用于日志、备份和告警的信息性事件。
这种不对称性是刻意的。在动作发生之前,状态仍然干净——你可以安全地说"不"。在动作发生之后,文件已经写入,命令已经运行。你可以观察和响应,但无法假装它没有发生。
配置:三层"何时、谁、做什么"
Hook 配置保存在 JSON 设置文件中,按三个嵌套层级组织:
json
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "command": "$CLAUDE_PROJECT_DIR/.claude/hooks/block-dangerous.sh"
          }
        ]
      }
    ]
  }
}
第一层 — 事件类型(PreToolUse):何时触发?
第二层 — 匹配器("Bash"):适用于哪个工具?支持精确匹配("Write")、多选("Edit|Write|MultiEdit")、通配符("*" 用于审计所有内容),或空字符串(用于没有工具的生命周期事件)。
第三层 — Hook 处理器:运行什么?每个处理器都有一个类型——command、prompt、agent 或 http——定义如何执行检查。
配置层次结构
设置从宽泛到具体级联:
- 用户级(
~/.claude/settings.json):个人偏好——通知、日志格式。 - 项目级(
.claude/settings.json):团队标准——提交到版本控制,让所有人获得相同的护栏。 - 本地覆盖(
.claude/settings.local.json):用于调试的临时调整。已 gitignore。 - 子智能体前置元数据:限定在单个子智能体生命周期内的 Hooks——例如,仅针对
db-reader智能体的 SQL 注入检查。
四种 Hook 执行类型
不是每种检查都需要相同的工具。原则是:使用能完成工作的最轻量机制。
| 类型 | 工作方式 | 最适合 | 成本 |
|---|---|---|---|
command | 运行 Shell 脚本。从 stdin 读取 JSON,通过退出码和 stdout JSON 返回决策。 | 确定性规则:黑名单、格式化、日志记录 | 最低 |
prompt | 将上下文发送给小型模型(如 Haiku)进行单次判断。 | 无法用正则表达式表达的模糊检查:"这段代码有明显的安全问题吗?" | 低 |
agent | 启动一个可访问 Read/Grep/Glob 工具的子智能体。 | 需要探索的复杂验证:"所有公开 API 都有文档吗?" | 高 |
http | 将事件数据 POST 到远程端点。端点返回 JSON 决策。 | 集中治理:共享安全扫描、团队级审计平台 | 可变 |
决策阶梯:command → prompt → agent → http。只有在更简单的选项确实无法满足需求时才升级。
PreToolUse:安全门
PreToolUse 是你防止灾难的地方。Hook 接收完整的工具调用 JSON(工具名称、参数、会话上下文)并返回决策:
exit 0加空 JSON{}:无意见,放行。exit 2加permissionDecision: "deny":阻止调用。Claude 看到原因并做出调整。exit 0加permissionDecision: "allow"+updatedInput:在执行前修改参数(例如,自动追加--dry-run)。
方案一:阻止危险命令
匹配 Bash,检查 tool_input.command,将永远不应在任何上下文中执行的模式加入黑名单:
bash
#!/bin/bash
# .claude/hooks/block-dangerous.sh
INPUT=$(cat)
COMMAND=$(echo "$INPUT" | jq -r '.tool_input.command // empty')

DANGEROUS_PATTERNS=(
  "rm -rf /"
  "rm -rf /*"
  "rm -rf ~"
  "> /dev/sd"
  "mkfs."
  "dd if="
  ":(){ :|:&"
  "git push --force origin main"
  "git push --force origin master"
  "git reset --hard origin"
  "DROP DATABASE"
  "DROP TABLE"
  "TRUNCATE"
  "curl.*| *sh"
  "curl.*| *bash"
  "wget.*| *sh"
  "wget.*| *bash"
)

for pattern in "${DANGEROUS_PATTERNS[@]}"; do
  if echo "$COMMAND" | grep -qi "$pattern"; then
    jq -n --arg reason "Blocked: matches dangerous pattern '$pattern'" '{
      hookSpecificOutput: {
        hookEventName: "PreToolUse",
        permissionDecision: "deny",
        permissionDecisionReason: $reason
      }
    }'
    exit 2
  fi
done

echo '{}'
exit 0
这能拦截从 fork 炸弹到强制推送的一切,无论是 Claude 还是凌晨 2 点昏昏沉沉的工程师触发了该命令。
方案二:保护敏感文件
不同的工具,不同的字段。对于 Write 和 Edit,敏感参数是 tool_input.file_path,而非 tool_input.command:
bash
#!/bin/bash
# .claude/hooks/protect-files.sh
INPUT=$(cat)
FILE_PATH=$(echo "$INPUT" | jq -r '.tool_input.file_path // empty')

SENSITIVE_PATTERNS=(
  "\.env$" "\.env\." "credentials\.json"
  "secrets\.yaml" "secrets\.yml"
  "\.pem$" "\.key$" "id_rsa" "id_ed25519"
  "\.ssh/config" "kubeconfig"
)

for pattern in "${SENSITIVE_PATTERNS[@]}"; do
  if echo "$FILE_PATH" | grep -qiE "$pattern"; then
    jq -n --arg reason "Protected file: $FILE_PATH cannot be modified" '{
      hookSpecificOutput: {
        hookEventName: "PreToolUse",
        permissionDecision: "deny",
        permissionDecisionReason: $reason
      }
    }'
    exit 2
  fi
done

echo '{}'
exit 0
配置 "matcher": "Write|Edit"。现在"永远不要碰 .env 文件"是一条可执行的策略,而非一种希望。
PostToolUse:质量循环
工具成功运行后,PostToolUse Hooks 可以做三件事:
- 后处理:自动格式化刚写入的文件。
- 检查并报告:运行 linter,报告结果。
- 注入反馈:通过
additionalContext将发现推送到 Claude 的上下文,触发其自我纠正。
第三种能力是神奇之处。它创造了一个自动反馈循环:Claude 写代码 → Hook 运行 ESLint → ESLint 报告三个警告 → Claude 在上下文中看到它们 → Claude 修复问题 → Hook 再次运行 → 干净。无需人工介入。
方案三:保存时自动格式化
bash
#!/bin/bash
# .claude/hooks/auto-format.sh
INPUT=$(cat)
FILE_PATH=$(echo "$INPUT" | jq -r '.tool_input.file_path // empty')

[ -z "$FILE_PATH" ] || [ ! -f "$FILE_PATH" ] && { echo '{}'; exit 0; }

EXT="${FILE_PATH##*.}"
case "$EXT" in
  js|ts|jsx|tsx|json|md|css|html)
    if command -v npx &>/dev/null; then
      npx prettier --write "$FILE_PATH" 2>/dev/null
      echo "{\"hookSpecificOutput\":{\"additionalContext\":\"Formatted $FILE_PATH with Prettier\"}}"
    else
      echo "{\"hookSpecificOutput\":{\"additionalContext\":\"Prettier not available\"}}"
    fi ;;
  py)
    if command -v black &>/dev/null; then
      black "$FILE_PATH" 2>/dev/null
      echo "{\"hookSpecificOutput\":{\"additionalContext\":\"Formatted $FILE_PATH with Black\"}}"
    else
      echo '{}'; fi ;;
  go) gofmt -w "$FILE_PATH" 2>/dev/null && echo "{\"hookSpecificOutput\":{\"additionalContext\":\"Formatted with gofmt\"}}" || echo '{}' ;;
  rs) rustfmt "$FILE_PATH" 2>/dev/null && echo "{\"hookSpecificOutput\":{\"additionalContext\":\"Formatted with rustfmt\"}}" || echo '{}' ;;
  *) echo '{}' ;;
esac
exit 0
注意优雅降级:如果格式化器未安装,Hook 会报告此情况,但不会阻止 Claude 的工作。用沉默处理缺失的工具,而非失败。
方案四:自动 Lint 并提供反馈
bash
#!/bin/bash
# .claude/hooks/lint-check.sh
INPUT=$(cat)
FILE_PATH=$(echo "$INPUT" | jq -r '.tool_input.file_path // empty')
EXT="${FILE_PATH##*.}"

case "$EXT" in
  js|ts|jsx|tsx) ;;
  *) echo '{}'; exit 0 ;;
esac

LINT_OUTPUT=$(npx eslint "$FILE_PATH" 2>&1 || true)
LINT_LINES=$(echo "$LINT_OUTPUT" | head -30)

if [ -n "$LINT_OUTPUT" ] && echo "$LINT_OUTPUT" | grep -q "error\|warning"; then
  ESCAPED=$(echo "$LINT_LINES" | jq -Rs .)
  echo "{\"hookSpecificOutput\":{\"additionalContext\":\"ESLint found issues:\\n${ESCAPED}\"}}"
else
  echo "{\"hookSpecificOutput\":{\"additionalContext\":\"ESLint: No issues found\"}}"
fi
exit 0
ESLint 后的 || true 防止非零退出码终止脚本。head -30 截断保持上下文注入精简——Claude 不需要 500 行的 lint 输出,只需前几个问题。
方案五:审计日志
对于受监管的环境(金融、医疗、政府),每个 AI 操作都需要留下记录:
bash
#!/bin/bash
# .claude/hooks/audit-log.sh
INPUT=$(cat)
TIMESTAMP=$(date -u +"%Y-%m-%dT%H:%M:%SZ")
TOOL_NAME=$(echo "$INPUT" | jq -r '.tool_name // "unknown"')
TOOL_INPUT=$(echo "$INPUT" | jq -c '.tool_input // {}')

LOG_DIR="${CLAUDE_PROJECT_DIR:-.}/.claude"
mkdir -p "$LOG_DIR"
echo "[$TIMESTAMP] $TOOL_NAME: $TOOL_INPUT" >> "$LOG_DIR/audit.log"

echo '{}'
exit 0
配置 "matcher": "*" 以捕获所有内容。这会生成每个工具调用的时间顺序记录——调用了什么、使用什么参数、何时调用。
Stop Hooks:"完成"意味着"已验证"
Stop 事件在 Claude 认为已完成时触发。没有 Stop Hook,"完成"只是意味着 Claude 停止生成。有了 Stop Hook,它意味着 Claude 的输出已通过你的验收标准。
机制:返回 { "decision": "block", "reason": "...", "continue": true } 强制 Claude 继续工作。返回 { "decision": "approve" } 允许其停止。
方案六:以测试为门控
bash
#!/bin/bash
# .claude/hooks/run-tests.sh
INPUT=$(cat)
STOP_ACTIVE=$(echo "$INPUT" | jq -r '.stop_hook_active // false')

# 防止无限循环:如果我们已经发回一次,就放行
if [ "$STOP_ACTIVE" = "true" ]; then
  echo '{"decision": "approve"}'
  exit 0
fi

# 自动检测项目类型并运行测试
if [ -f "package.json" ] && grep -q '"test"' package.json; then
  TEST_OUTPUT=$(npm test 2>&1 || true)
elif [ -f "pytest.ini" ] || [ -f "setup.py" ] || [ -d "tests" ]; then
  TEST_OUTPUT=$(pytest 2>&1 || true)
elif [ -f "go.mod" ]; then
  TEST_OUTPUT=$(go test ./... 2>&1 || true)
elif [ -f "Cargo.toml" ]; then
  TEST_OUTPUT=$(cargo test 2>&1 || true)
else
  echo '{"decision": "approve"}'
  exit 0
fi

TRUNCATED=$(echo "$TEST_OUTPUT" | tail -50)

if echo "$TEST_OUTPUT" | grep -qiE "failed|error|FAIL"; then
  jq -n --arg msg "Tests failed. Fix the issues and try again:\n$TRUNCATED" '{
    decision: "block",
    reason: $msg,
    continue: true
  }'
  exit 0
else
  echo '{"decision": "approve"}'
  exit 0
fi
stop_hook_active 字段至关重要——它是 Claude Code 的内置断路器。当 Stop Hook 将 Claude 发回工作时,下一个 Stop 事件包含 stop_hook_active: true。用它来实现"重试一次,然后放行"的逻辑,避免无限修复-重试循环。
子智能体 Hooks:委托工作的治理
当 Claude 委托给子智能体时(通过 Task 工具),两个额外的 Hooks 允许你治理委托行为:
SubagentStart — 在子智能体开始前注入上下文。你无法阻止启动,但可以通过 additionalContext 提供团队规范、当前分支名称或需要关注的模块。这自动化了"别忘了告诉审查者我们的命名规范"这一仪式。
SubagentStop — 在接受子智能体的输出之前验证它。与主 Stop Hook 一样,你可以返回 "block" 将其发回继续工作。输入包含 agent_transcript_path,因此你的验证脚本可以读取子智能体的完整对话——判断过程质量,而非仅仅判断最终答案。
一个实用模式:对于 code-reviewer 子智能体,检查记录是否同时包含问题识别和可操作的建议。如果它只找到问题而没有推荐修复方案,则将其发回,附上完成审查的说明。
整合起来:两种参考架构
架构一:纵深防御(安全)
PreToolUse(Bash) → block-dangerous.sh     # 第一层:防止灾难性命令
PreToolUse(Write|Edit) → protect-files.sh  # 第二层:保护敏感资源
PostToolUse(*) → audit-log.sh             # 第三层:记录一切
这些层次遵循"强度递减,覆盖递增"的模式。第一层以确定性阻止少量毁灭性操作。第二层保护更广泛的敏感操作类别。第三层记录所有内容用于事后分析——即使有东西漏网,你也会知道发生了什么。
架构二:质量流水线
PostToolUse(Write|Edit) → auto-format.sh   # 阶段一a:规范风格
PostToolUse(Write|Edit) → lint-check.sh     # 阶段一b:捕获局部问题
Stop → run-tests.sh                         # 阶段二:全局验收门
阶段一在每次文件保存时运行——增量式、快速、局部。阶段二在 Claude 说"我完成了"时运行一次——全面、较慢、全局。先格式化后 lint(以便 lint 检查最终形式),测试在发布前运行。
高级模式
多 Hook 链: 同一事件上的多个 Hooks 按数组顺序运行。如果任何一个返回"block",后续 Hooks 将被跳过。将必须始终运行的 Hooks(日志)放在可能阻止的 Hooks(验证)之前。
环境注入: SessionStart Hooks 可以向 CLAUDE_ENV_FILE 指定的文件写入 export 语句,为整个会话的 Bash 调用设置变量,如 NODE_ENV 或 DEBUG。
异步 Hooks: 在 command 类型的 Hooks 上设置 "async": true,用于即发即忘场景——后台测试运行、Slack 通知、外部 API 调用。它们不阻塞主流程;结果作为上下文在下一个对话轮次中出现。
前置元数据 Hooks: 在命令或技能的前置元数据中定义 Hooks,用于临时的、有范围的执行。添加 once: true 仅在第一次匹配时触发。适用于在继续之前需要一次性安全检查的部署命令。
调试技巧:
- 始终将调试输出写入
stderr(echo "DEBUG: ..." >&2)。stdout上的任何内容都必须是有效的 JSON。 - 在本地测试脚本:
echo '{"tool_input":{"command":"rm -rf /"}}' | bash .claude/hooks/block-dangerous.sh; echo "Exit: $?" - 运行
claude --debug查看 Hook 执行追踪。 - 常见陷阱:匹配器字符串中的拼写错误、脚本缺少
chmod +x、Shell 配置文件在非交互式会话中向 stdout 输出内容。
设计哲学
有效的 Hook 工程建立在三个原则之上:
1. 确定性优先。 如果规则可以用 Shell 脚本表达,就不要交给 LLM。脚本快速、可测试、可预测。LLM 用于模糊边界——"这段代码感觉对吗?"——而非"这个文件名是否匹配 .env?"
2. 事前门控,事后观察。 使用 PreToolUse 阻止不可逆的损害(破坏性命令、敏感文件写入)。使用 PostToolUse 和 Stop 进行质量反馈和清理。你无法恢复被删除的生产数据库,但你总可以重新运行格式化器。
3. 范围要窄,层次要广。 用户级 Hooks 用于个人偏好。项目级 Hooks 用于团队标准。子智能体前置元数据 Hooks 用于特定领域的约束。每一层都增加覆盖范围,而不越界。
结果是一个系统,让 Claude 专注于创造性的、需要高度判断的工作——设计架构、编写业务逻辑、解决新问题——而 Hooks 在底层处理机械的、不可妥协的规则。Claude 是开发者;Hooks 是 CI/CD 流水线、linter 配置、分支保护规则和安全策略——全部集成在一个可编程的事件系统中。
你不只是在用 Claude 写代码了。你在构建一个以 Claude 为组件的工程系统——可审计、受治理、安全由设计保障。
有关完整的事件 schema、JSON 格式以及 HTTP Hooks 和 MCP 工具 Hooks 等高级功能,请参阅 Hooks 参考文档。如需实践演练,从 Hooks 指南开始。如果你构建了有用的 Hook 集合,可以考虑将其打包为 Claude Code 插件,与团队和社区分享。