Appearance
工具、MCP、CLI 及更多
2026 年 AI 工具集成大辩论——以及为什么答案并不像选边站那么简单。
引发战争的 USB-C
2024 年底,当 Anthropic 将模型上下文协议(MCP)开源时,这个提案令人无法抗拒:一个"AI 的 USB-C",让任何模型都能通过一个通用协议与任何外部服务通信。不再需要为每个 API 进行定制集成,不再有 M×N 的适配器地狱,只需 M+N。
业界买账了——而且力度相当大。OpenAI、Google、Microsoft、Amazon 全都采用了它。到 2026 年 2 月,MCP 的月 SDK 下载量已突破 9700 万次,超过 5800 个已验证的服务器。2025 年 12 月,Anthropic 将 MCP 捐赠给 Linux 基金会的 Agentic AI Foundation,表明这不再只是一家公司的私人项目,而是基础设施。
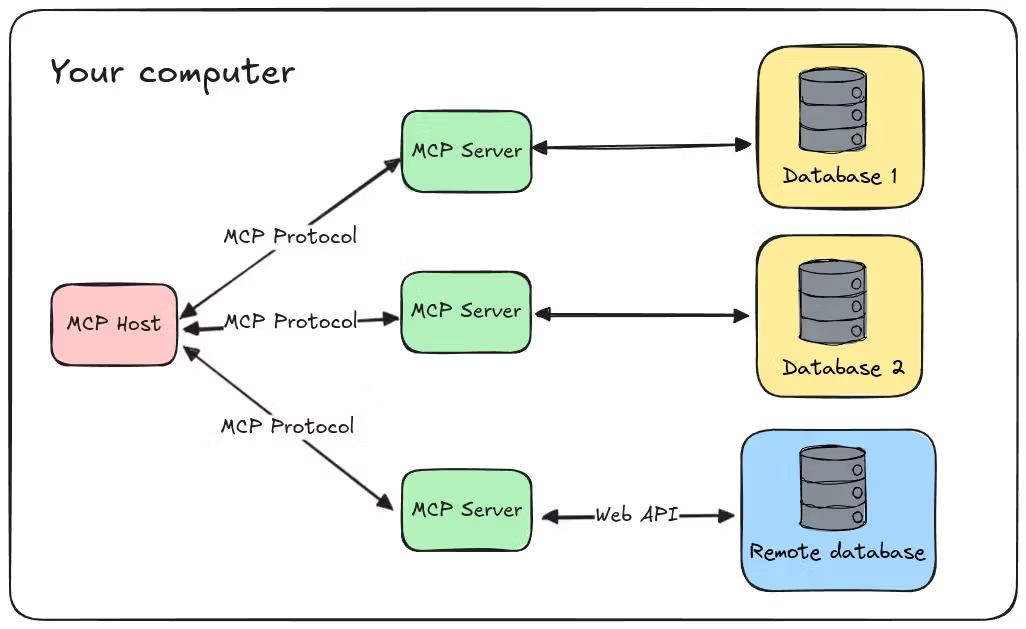
然后,在 2026 年 3 月 11 日,Perplexity 首席技术官 Denis Yarats 在 Ask 2026 大会上说出了许多 AI 工程师私下低语的话:MCP 对生产智能体系统来说成本太高了。Perplexity 内部正在放弃 MCP,转而使用传统的 REST API 和 CLI。Y Combinator 首席执行官 Garry Tan 独立构建了一个基于 CLI 的智能体集成,而没有使用 MCP。Cloudflare 几个月前就已发布其"Code Mode"方案,与原始 MCP 工具调用相比,token 用量减少了 99.9%。
标题颇为戏剧化:"MCP 已死"、"CLI 是新的 MCP"、"Perplexity 抛弃 MCP"。
但现实,正如工程中的大多数事情一样,更为微妙。让我来带你了解实际发生了什么、为什么重要,以及如果你今天在构建 AI 智能体系统,该如何思考这个问题。
核心问题:上下文窗口的经济学
要理解 MCP 与 CLI 的争论,你需要理解一个数字:token。
每个 AI 模型都有一个有限的上下文窗口——它在工作内存中可以同时容纳的总文本量。所有内容都在竞争这个空间:用户的问题、系统提示词、检索到的文档、对话历史,以及工具定义。
MCP 的麻烦就在这里。当你连接一个 MCP 服务器时,该协议会将它提供的每个工具的完整 schema 倾倒到智能体的上下文窗口中——工具名称、描述、参数定义、响应格式,一应俱全。GitHub 官方 Copilot MCP 服务器暴露了 43 个工具。要回答"这个仓库用什么语言写的",智能体只需要其中 1 个工具,却要携带全部 43 个的定义。
Scalekit 对相同的 GitHub 任务进行了 75 次基准测试,比较 CLI 和 MCP 方案。对于最简单的查询——仓库语言检测——CLI 智能体消耗了 1365 个 token。MCP 智能体:44026 个 token。差距是 32 倍,几乎全部来自 schema 开销。
规模越大,情况越糟。Apideck 记录了一个部署案例,三个 MCP 服务器(GitHub、Slack、Sentry)在智能体处理任何用户消息之前就消耗了 20 万个可用 token 中的 14.3 万个——占上下文窗口的 72%。
Token 不只是成本指标,它直接决定了智能体在实际任务中剩余多少推理能力。当 40%-72% 的上下文窗口被工具定义占据时,模型用于思考、规划和执行的空间就更少了。
为什么 CLI 出人意料地好用
CLI 作为智能体接口的故事建立在一个看似巧合实则必然的基础上:LLM 是在互联网上训练的,而互联网充满了 Shell 命令。
Claude 等模型在训练数据中见过数百万个 git、gh、kubectl、aws、curl、jq 以及其他常用 CLI 工具的示例。它们知道命令、标志、常见模式和错误信息。当你给智能体一个 bash Shell 并说"列出这个仓库的开放 PR",它会生成 gh pr list --state open,完全不需要任何 schema 注入。工具定义消耗零 token。模型已经知道这个接口了。
这种训练数据优势以三种方式叠加:
可组合性。 Unix 管道深深嵌入模型权重。见过数千次 find . -name "*.py" | xargs grep "import" 的模型可以即兴创作相同模式的新组合。MCP 没有原生的链接机制——为它添加工具间调用和流水线定义的努力,本质上是在重新发明 Unix 在 20 世纪 70 年代就已解决的问题。
自我文档化。 每个 CLI 都附带 --help。智能体可以在运行时发现功能,无需任何前期 schema 成本。需要知道 terraform plan 做什么?运行 terraform plan --help。这是渐进式披露——只有在真正需要时才为文档付出 token 代价。
生态系统成熟度。 GitHub 有 gh,AWS 有 aws,Kubernetes 有 kubectl,Docker 有 docker。这些 CLI 由服务提供商自己维护,自动跟踪 API 变化,处理认证、分页和错误处理。它们已经被数百万开发者在生产环境中经过多年甚至数十年的实战检验。
但 MCP 并没有死
问题在这里,话语走偏了。"MCP 已死"的叙事部分源于真实的工程顾虑,部分源于销售替代方案的公司。Apideck 销售 API 集成产品,Scalekit 销售开发者基础设施,Perplexity 在推广自己的 Agent API。他们的数据是真实的,但他们的框架有利益角度。
让我为 MCP 的立场做一个有力辩护,因为 CLI 倡导者倾向于轻描淡写地回避 MCP 解决的真实问题。
多租户问题
当你是独立开发者自动化自己的工作流时,CLI 是完美的。你的 ~/.aws/credentials 文件有你的 token。你的 gh 已经认证到你的 GitHub。你的 Shell 以你的用户权限运行。
但一旦你越过"我在自动化我的工作流"到"我的产品在为我的客户自动化工作流"的边界,CLI 的优势就变成了负担。用谁的凭证?如何按客户限定权限范围?当客户流失时如何撤销访问权限?如何审计智能体代表谁调用了哪些工具?
MCP 的 OAuth 2.0 集成、动态客户端注册和结构化权限模型的存在,正是因为企业 SaaS 部署需要这些基础设施。当你需要跨数十个第三方服务进行用户级授权范围控制时,带着 Bearer token 的 Shell 是不够的。
非开发者用户
销售总监不能也不应该需要解读 stderr 错误追踪。CLI 接口之所以强大,是因为它们富有表达力且可组合,但它们本质上以开发者为中心。MCP 的结构化工具 schema 虽然 token 成本高,但在模型和终端用户之间提供了一个清晰的抽象层。模型知道每个工具做什么、它期望什么参数、它返回什么——所有这些都以为机器消费而非人类 Shell 高手设计的格式呈现。
没有 CLI 的服务
并非每个服务都有 CLI。许多内部企业工具、利基 SaaS 产品和自定义业务系统只暴露 REST API 或专有接口。对于这些,MCP 提供了一种标准化的方式,将任何 API 包装为任何 MCP 兼容智能体都可以发现和使用的工具。没有 MCP(或类似的东西),你就得回到为每个服务编写一次性集成代码。
动态发现
MCP 的杀手级功能不是协议开销——而是智能体可以连接到一个它从未见过的服务器,并立即理解哪些工具可用。这种动态发现正是使生态系统成为可能的原因。CLI 要求模型要么已经从训练数据中知道该工具,要么通过 --help 探索它——这对专有或自定义工具不起作用。
第三条路:Code Mode 与渐进式披露
当 MCP 与 CLI 的辩论在社交媒体上激烈进行时,从业者们正在悄悄收敛于混合方案,兼取两者之长。
Cloudflare 的 Code Mode 是最优雅的例子。与其将 2500 个 API 端点暴露为单独的 MCP 工具(这将耗费约 24.4 万个 token),Cloudflare 的 MCP 服务器只暴露两个工具:search() 和 execute()。智能体针对类型化 SDK 编写 JavaScript 代码来与 API 交互。总 schema 成本:约 1000 个 token。减少了 99.9%,同时保留了 MCP 的发现和连接管理优势。
核心洞见:LLM 写代码的能力远强于消费工具 schema。它们在训练数据中见过的 TypeScript 远多于 MCP 工具调用的合成示例。Code Mode 通过将问题从"选择并调用正确的工具"转化为"编写一小段程序"来利用这一点——而这正是模型已经擅长的事情。
Anthropic 自己的修复走向类似方向。Claude Code 推出了工具搜索的懒加载——与其预先倾倒所有工具 schema,它只加载与当前任务相关的 schema,在完全遵守 MCP 协议的情况下实现了 98.7% 的 token 减少。
CLI 渐进式披露,由 Apideck 倡导,用按需 --help 调用替换 MCP schema,从大约 80 个 token 开始,而非数万个。
共同主线:问题不在于 MCP 作为协议本身。问题在于 MCP 的"预先加载所有内容"的默认行为。 修复这一点,token 经济就会大幅改善。
面向从业者的决策框架
消化了这一切之后,以下是我今天对 AI 智能体系统工具集成的思考方式:
从 CLI 开始,如果:
- 服务已有成熟的 CLI(GitHub、AWS、Kubernetes、Docker 等)
- 你为开发者或内部工具构建
- 智能体以单一已知用户的凭证运行
- 需要最大的 token 效率
- 通过管道实现可组合性对你的工作流很重要
使用 MCP,如果:
- 你需要跨智能体从未见过的服务进行动态工具发现
- 你在构建需要用户级 OAuth 和权限范围控制的多租户产品
- 服务没有 CLI 且只暴露 API
- 你需要带遥测的结构化、可审计的工具调用
- 你在 IDE/桌面环境中(Cursor、Claude Desktop、VS Code),其中 MCP 原生支持
考虑 Code Mode / 混合方案,如果:
- 你需要访问大型 API 表面(数百或数千个端点)
- token 效率很重要,但你仍然想要 MCP 的发现和认证优势
- 你的智能体能够编写和执行代码
务实的默认选择: 对所有有 CLI 的服务使用 CLI。没有 CLI 时,用薄薄的 CLI 脚本包装 API。当需要 OAuth、多租户或动态发现时才使用 MCP。无论选择哪种传输方式,都要在工具接口的质量上大量投入——清晰的名称、精确的描述、范围适当的参数。工具设计比协议更重要。
接下来
MCP 规范自 2025 年 11 月以来没有发布新版本。2026 年路线图将企业就绪列为其四个优先事项中定义最不清晰的一个。认证这个最常被引用的痛点,虽已被承认但尚未解决。与此同时,生态系统继续碎片化:Perplexity 的 Agent API、Cloudflare 的 Code Mode、Apideck 的 CLI 方案,以及无数团队悄悄构建自己的集成。
但网络效应很强大。当 Anthropic、OpenAI、Google 和 Microsoft 都支持同一个协议时,开发者就会为它构建,不管有什么缺陷。没有人使用 HTTP 是因为它是有史以来设计最优雅的协议,而是因为所有东西都在使用它。MCP 可能会走同样的路——不是因为它最优,而是因为它无处不在。
明智的赌注不是选边站,而是设计你的智能体架构,使工具传输层是可插拔的。让 CLI 和 MCP 在集成边界处可以互换。为每个具体的集成使用合适的工具。并记住,六个月后,话语会转移到下一件事——但你的生产系统仍然需要运行。
Unix 哲学在五十年前就说对了:专注做一件事,自由组合,保持接口简单。无论这些接口说的是 JSON-RPC 还是 stdout,这个原则都成立。