广告系统Overview
广告是怎样投放出来的?
竞价广告整体流程:广告候选 -> 模型打分 -> 竞价/计费(ctr cvr bid 二价收费)-> 用户反馈 -> 模型训练
-
Before Send:
- 发起请求,调用核心调度组件
- 核心组件调度混合处理流程,依次完成:
- 从海量候选中进行初步召回,筛选出候选集(考虑定向、频控、流控等因素)
- 对召回结果进行粗排序,将候选数大幅缩减
- 对粗排后的候选进行精细排序,通过预估并校准CTR/CVR分值
- 返回包含预估分值的最终候选数据
- 返回候选结果的同时,执行计费处理
-
After Send:
- 发送确认信号(ack),同时更新计费、流控和会话状态,并将部分特征数据推送用于后续处理
- 样本拼接:
- 收集特征数据(来源于预排序时输出的数据流)
- 收集行为标签(send、show、click、convert等日志记录)
- 根据请求标识匹配特征与标签,组装后将样本送入消息队列供后续模型更新
- 模型流式更新:
- 通过流任务从消息队列读取样本以进行实时训练,更新模型参数
- 定时同步最新参数到线上预测模块,确保预估效果
广告策略和系统的关系概览
流量变现角色与诉求:流量变现主要有平台、客户、用户三个参与角色,平台要最大化收入,需调和三方利益,打造复杂广告系统。
广告系统模块:精排前减轻预估压力,精排估准价值排序,精排后主要由自然内容排序规则支配。
排序:精排依据预期挣钱多少排序,涉及多个参数和公式,门槛ecpm_thres影响广告投放和计费。
出价:对广告主是表达诉求,对平台是约束和策略抓手,出价公式复杂,调参任务重。
转化:如何定义转化、会同时影响模型和出价
归因:对广告主计算ROI、平台计费和模型表现都很重要,涉及谁归因、付费事件等多方面问题
广告vs推荐vs搜索
业务层面不同
| 维度 | 搜索 | 推荐 | 广告 |
|---|---|---|---|
| 用户驱动 | 主动明确需求 | 被动激发潜在需求 | 半主动,推测需求 |
| 商业化目标 | 较弱 | 中等 | 强 |
| 反馈类型 | 显式反馈(点击、跳转) | 隐式反馈(浏览、停留) | 显式+转化反馈(购买、注册) |
| 策略难点 | 理解意图、实时性 | 个性化、多样性平衡 | 商业目标与体验平衡 |
系统层面不同
- 候选池大小差别
- 推荐/搜索:百亿量级
- 广告:百万量级
- 最终目标不一样
- 搜索:排序任务
- 按照和query的相关性排序(Learn to Rank)
- 推荐
- 直接优化单次Request上E(Ri) (eg. staytime)
- 个性化要求更强(缺少query),挖掘更多feedback
- 广告
- 需要知道具体分值(ctr,cvr)
- 搜索:排序任务
- 模型假设不同
- 搜索
- Information Retrieval(PageRank) + Machine Learning to Rank
- 推荐
- 在线离线不一致:单request的用户反馈与长期满意度之间的相关性复杂,离线指标与在线收益并不一致。(staytime vs stay duration)
- 离线目标不明确:建模多种单request用户反馈来approximate用户的长期满意度。解决两个问题:
- 1)优化哪些单request用户反馈?(寻找新的单request用户反馈行为作为新目标。目的是找到长期满意度的“短期近似”)
- 2)如何将各单request反馈合并进行排序?(调节融合公式,使得多种单request用户反馈能更好得approximate用户长期满意度)
- 策略导向:推荐模型本质上在处理一个控制问题。迭代目的不是简单的提升精度,而是希望能优化推荐策略–寻找用户长期满意度的短期近似,并优化。
- 各个request之间不独立:模型需要进行多步优化来提升用户跨越多个request的反馈。这种优化更接近优化用户长期满意度。(Listwise推荐优化,提升一刷视频列表的多样性)
- 广告
- 在线离线一致:离线指标(衡量单次request收益),与在线收益(衡量总收益)有较强的一致性 (request次数受广告本身变化影响较点击率小)
- 离线目标明确:由于排序公式(ecpm)相对清晰,离线训练的label明确,如pctr,pcvr
- 精度导向:广告模型本质处理预测问题,迭代的方向是提升预测精度
模型架构一致
- 召回 -> 粗排 -> 精排
- 搜索
排序 (Ranking)
- Ranking是广告投放的核心问题,我们用sorted_eCPM指标来评估这一目标:
- sorted_eCPM = eCPM + hidden_cost
- eCPM = pctr pcvr rank_bid,是平台预估的千次展现收益
- rank_bid是考虑了风控流控等策略后系统修正的cpa_bid
- hidden_cost是考虑用户体验/平台生态等因素后的控制项(冷启动/稳定性,dislike,扶持等,体现用户价值/生态价值,广告策略的主要抓手)
- 广告系统做的就是从千万量级的广告库中找出最有价值的一条广告(对于每个请求)
召回
解决问题:原始百万级广告中筛选出万量级广告
模型特点:【多路、检索】
建模目标:预估召回的目标 (ANN/量化)(无监督) -> 直接预估召回结果(DR)(监督)
建模挑战:广告量太大(1000亿成交额,100亿点击,100000亿曝光);时间短(100ms以内,精排10ms);定向条件(600w bitmap)
常见算法
Key-value召回
(倒排索引) 召回:线地筛选出可推item,然后根据对应的规则构建倒排,然后每个key里面的item也可以根据一定的算法得到对应的score,根据score排序之后写入到kv存储里面。score考虑的因素可以是:曝光、点击、创建时间、点赞、分享、时长、跟key的相关性等
向量化召回 :ANN(Approximate Nearest Neighbor)以及Quantization
向量化召回:一般是指query是一个embedding,然后根据query来计算得到相似的item,作为召回的结果。构建召回阶段,主要是获取到候选的item,得到候选item的embedding,然后再根据embedding利用不同的算法进行预处理,得到线上可快速搜索的结构,最后把构建好的数据dump下来,然后发到线上供召回使用。在线召回阶段,load离线dump的数据,然后rebuild对应的模型结构,构建完成之后就可以进行召回处理了(加各种过滤规则)
- 分别包含:User 侧、group侧、context侧,相关还会包括src gid
聚类算法:Ann(approximate nearest neighbor)
是指一系列用于解决最近邻查找问题的近似算法。最近邻查找问题,即在给定的向量集合中查找出与目标向量距离最近的N个向量。
-
KNN:Space Partitioning Problem. 最直白的想法就是挨个求一遍内积,返回相似度最大的K个. 但是,online挨个算一遍太慢了,所以第二直白的想法就是离线计算时将样本集按照一定规则组织成一个树结构,然后进行在线Query时,仅需要遍历部分节点,而不是将全部的样本都在线算一遍。
-
Ball Tree:ball tree将在一系列嵌套的超球体上分割数据。也就是说:使用超球面而不是超矩形划分区域。虽然在构建数据结构的花费上大过于KDtree,但是在高维甚至很高维的数据上都表现的很高效。
-
Fast Ball Tree(FBT)(技术分享-Fast Ball Tree ):Fast ball tree 主要是把 tree 结构在serving 时都去掉了,直接计算底层叶子节点, 相当于 tree 只是用来加速聚类. 目前的新方 也有采用 gpu 直接 kmeans 的方案,hnsw 来做聚类树的方案,总体来看层次化聚类已经被淘汰了
-
Hierarchical Navigable Small World (HNSW)(ANN-HNSW 算法)
-
NSW设置最低近邻点个数,将样本点和其近邻连接起来,构建了一个无向图。每当查询(插入)一个新的样本点时,通过高速公路机制加快近邻点搜索,并找到无向图上离该点最近的m个近邻点(m按需要设置),若插入则将该点和其m个近邻点连接起来
-
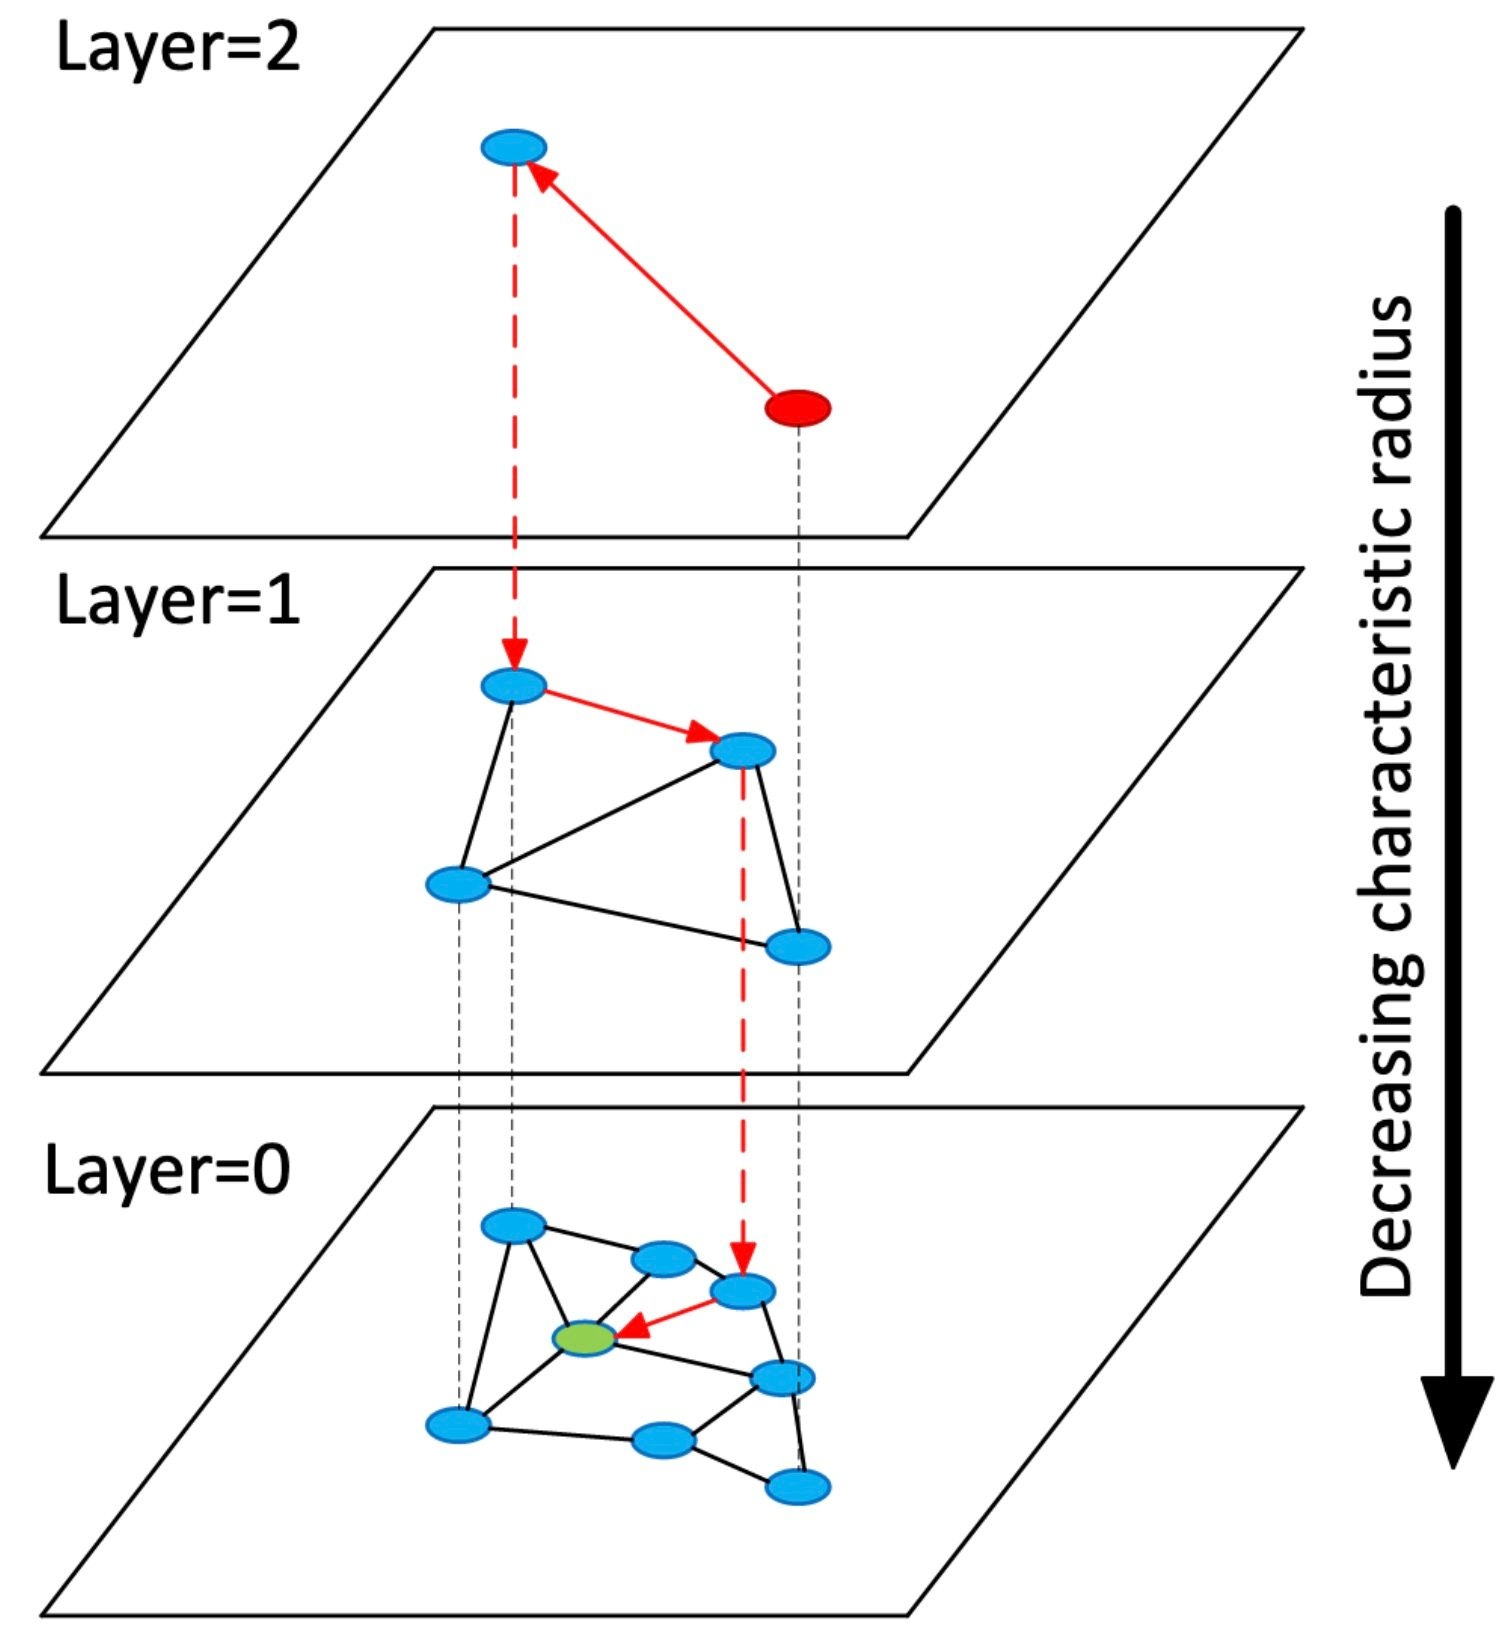
hnsw的主要思路是将所有的item构建一个多层的邻近图,加快在线的搜索效率。(NSW + Skip List)
-
-
-
IVF_PQ介绍:ivf的主要目的就是给聚类的结果构建一个倒排,key为聚类的id,value为当前聚类id下的所有候选。
-
ANN缺陷
- ANN只能对召回广告的“质量”做出一个下界的保证,但无法对召回率做出保证。
- 在广告场景下,当引入定向信息后,ANN对召回质量也无法保证。
- 当广告库增大而其他参数(聚类数、召回数)不变的情况下,ANN的召回率会恶化。
- 类似于CTRCVRBID的方式无法适配到ANN的架构上,这也使得过去的召回模型的尝试局限于单目标形式,将精排预估结果作为gound truth,间接地拟合ecpm。
-
Quant Recall(量化召回)(Loss-aware Quantization for Recall )(可以在ANN框架下,也可以脱离ANN,直接暴力计算)
-
量化召回 Brute-force Retrieval (Quantization + GPU) On Douyin Ads
- Q为量化函数,t_u和t_a为我们要学习的一组阈值,q为目标bit数(在我们的场景中q=8),t_u^k是t向量的第k个元素。即,当量化函数的复杂度在q以内时,最大化內积保序的概率。在实践中我们发现(方案见技术实现),使用8bit的量化能够实现离线ndcg的损失在万分2以内。
- 和ANN可结合:ANN+定向结合方法
- Index Rule Learning解决方案目前的召回模型是在召回后再与定向规则取交集(二者并行),实际上召回了许多不能通过定向的广告,浪费了许多资源,也降低了召回模型的效果(本来可以召回更多符合定向规则的广告);IRL的基本思路是,用户的少量信息(如城市、性别等)就能筛选掉许多定向条件不符合的广告,那么挑选出这些信息量大的特征,就可以在召回时使用这些特征,如果判断不能通过定向规则无需继续计算。
- Index Rule Learning解决方案简化版 Index Rule Learning读后感
Deep Retrieval (KDD 21, ByteDance AI Lab)
Deep Retrieval 介绍 deep retrieval
DR希望能够在学习的同时构建一个可以搜索的结构,从而能把学习的目标和召回更加直接的联系起来。从这个角度来讲,DR和近似近邻搜索算法在本质上有较大的不同。
Deep Retrieval的主要贡献:
- 打破点乘或者距离搜索限制,索引可以和任意深度复杂结构同步,端到端的学习
- Graph编码,单物件(group, ad)可以赋予多个索引,增强物件的表征形式
- 采用online EM算法支持流式更新
- 算法系统为产品而设计,支持大规模分布式在线学习,高效支持大规模候选集与复杂过滤逻辑
- 证明了端到端学习在大规模召回场景的理论和实际上的可行性,给了我们未来更大的想象空间
召回策略
- 各类召回路逻辑(业务逻辑 & 模型逻辑)和过滤策略的迭代;需要在系统资源限制下同时满足和平衡三方诉求和各行业平衡
- 和定向策略结合,为广告主找到合适的受众(”猜你喜欢“)
粗排
解决问题:从万量级的广告中优选出几百个广告
模型特点:【双塔、广告侧向量缓存、无交叉特征】
建模目标:有监督,L2R vs 直接预估ctr, cvr等
建模挑战:降低计算复杂度
LTR
- Pointwise方法将文档(广告)转换为特征向量后,让模型对每个文档(广告)单独打分,打分结果就是模型输出。Pointwise模型学习的是文档(广告)在给定查询下的相关性
- Pairwise方法则主要考虑文档(广告)之间的先后顺序。每两个文档(广告)形成一个文档(广告)对,并有二者之间的先后顺序。模型学习和输出的都是文档(广告)对之间的先后顺序。这也是我们的LTR模型目前所采用的的方法,值得一提的是,pairwise方法考虑了两个文档(广告)对的相对先后顺序,却没有考虑文档(广告)出现在列表中的位置,排在前列的文档(广告)更为重要,如果靠前的文档(广告)出现判断错误,代价明显高于排在后面的文档(广告)。
- Listwise方法将一个查询(请求)对应的所有结果列表作为一个实例。文档列表方法根据K个训练实例(一个査询(请求)及其对应的所有结果评分作为一个实例)训练得到最优评分函数F,对于一个新的用户査询(请求),函数F对每一个文档(广告)打分,之后按照得分顺序由高到低排序,就是对应的结果。 所以关键问题是:拿到训练数据,如何才能训练得到最优的打分函数?
常见算法(90s - 2010s) - RankSVM
- GBDT
- RankNet(Logistic Regression)
- 定义损失函数(Loss Function)来描述如何引导模型学习正确的两两关系。(这个信息可以是二元的,比如 +1 代表更加相关,-1 代表更加不相关,注意这里的“更加”表达了次序关系。)
- 使用一个二元分类器的办法来处理这样的关系。RankNet 在这里使用了“对数几率损失函数”(Logistic Loss),有了损失函数之后,训练神经网络。
- LambdaRank, LambdaMART
- 定义两个文档之间的差距是这两个文档互换之后 NDCG 的变化量,同时这个变化量等于损失的梯度,那么我们就可以指导 RankNet 去优化 NDCG。博格斯和其他作者把这个损失的梯度定义为 Lambda,因为整个过程是在优化一个排序,所以新的方法叫做 LambdaRank。
- LambdaMART: 使用GBDT
LTR Metrics
搜索系统的离线测评
- 基础:Precision, Recall, AUC
- 二元相关指标:
- Discounted Cumulative Gain:
- 一个排序的整体相关度,是这个排序的各个位置上的相关度的某种加权
- 其次,每个位置上面的“获得”(Gain)是和这个文档原本定义的相关度相关的,但是,根据不同的位置,要打不同的“折扣”。位置越低(也就是位置数越大),折扣越大。这就是 DCG 名字的由来。
- 在原始的 DCG 定义中,“折扣”是文档的相关度除以位置的对数转换。这样,既保证了位置越低(位置数大),折扣越大,还表达了,高位置(位置数小)的差别要大于低位置之间的差别。
- 假设我们有 5 个文档,假定他们的相关度分别是 1、2、3、4、5,分别代表“最不相关”、“不相关”、“中性”、“相关”和“最相关”。那么,在 DCG 的定义下,最佳的排序就应该是把这 5 个文档按照相关度的顺序,也就是 5、4、3、2、1 来排定。任何其他的顺序因为根据位置所定义的“折扣获得”的缘故,都会取得相对较小的 DCG,因此不是最优。DCG 比“精度”和“召回”能够更好地表达对排序的评估。
- DCG 加以“归一化”的指标叫做 nDCG (Normalized Discounted Cumulative Gain)
- 直接使用 DCG 也存在一个问题。如果我们有两个查询关键字,返回的文档数不一样,那么直接比较这两个查询关键字的 DCG 值是不“公平”的。原因在于 DCG 的“加和”特性,结果肯定是越加越大,因此不能直接比较两个不同查询关键字的 DCG 值。
广告系统的问题:离线和在线指标一致性
- 直接使用 DCG 也存在一个问题。如果我们有两个查询关键字,返回的文档数不一样,那么直接比较这两个查询关键字的 DCG 值是不“公平”的。原因在于 DCG 的“加和”特性,结果肯定是越加越大,因此不能直接比较两个不同查询关键字的 DCG 值。
- Discounted Cumulative Gain:
- 会出现NDCG等指标变好,线上没有收益的情况,需要研究多种指标
R2S模型
-
精排型的简化版
-
更有利于学习Top广告
-
R2S: 2分类问题,sorted_ecpm最高的广告为正例,其余为负例,优化sigmoid_cross_entropy_with_logits,但是这种样本的构造把正负例label基本设置成独立的事件,也就是P(y_i=label | x)
- 但是对于粗排场景,正负例其实是和候选list有关,其概率是P(y_i=label |x, list), 开了实验 ab-link 也证明了,二分类交叉熵loss没有收益
-
Softmax Loss(ecpm回归转分类模型 Weighted Cross-Entropy )将粗排看作是一个多分类问题,也就是在众多的候选中选出sorted_ecpm最高的广告
- 设计的label形式为[1,0,0,0]这种,其中sorted_ecpm最高的label为1,其余为0;优化的loss为softmax_cross_entropy_with_logits;
- (实际情况是先从候选中采样了4个样本,然后将这4个样本应用于计算loss,本质上应该是一个sampled-softmax-loss,因为还无法估计采样的分布函数Q(x_i),因此此处假设采样的分布为 Q(x_i) = 1/|v_list| if x_i in v_list else 0,这样的话sampled-softmax-loss基本可以等同于softmax_cross_entropy_with_logits)
- softmax-loss表现形式上和ltr-loss只用包含top1 item的pair loss相似
- 设计的label形式为[1,0,0,0]这种,其中sorted_ecpm最高的label为1,其余为0;优化的loss为softmax_cross_entropy_with_logits;
-
特征
- 通过之前精排梳理的SparseNAS ADN 特征重要性与 afs 用户侧特征统一抽取上线,新加部分特征,详见 R2S新加特征。
-
发展方向:Deep化
粗排策略
- 粗排模型迭代较多 策略迭代较少
- 因为粗排通常是近似精排、如策略有迭代会迭代精排排序目标
精排
CTR Prediction Problem
解决问题:几百个广告选出最好的
模型特点:【双塔、广告侧向量缓存、特征交叉】
建模目标:预估CTR和CVR ~ f(user, content, ads)
建模挑战:
- 数据
- 转化稀疏,正例的数目常常是负例的百分之一或者千分之一,造成的就是非常“不均衡”的数据集。以及由此带来的
- 探索问题,Bias(Bias & Debias )
- 上下文变化(信息流vs搜索),Variance(精排Variance度量(WIP) Variance度量[WIP] )等
- 目标函数 - 比搜索和推荐复杂
- 排序——选择合适的广告展示
- 预测——合适的出价,最终能够竞胜的出价
点击率预测问题
历史
- 二分类 Logistic Regression(KDD2013, Google)
- 普通的逻辑回归并不适应大规模的广告点击率预估。有两个原因,
- 第一,数据量太大。传统的逻辑回归参数训练过程都依靠牛顿法(Newton’s Method)或者 L-BFGS 等算法。这些算法并不太容易在大规模数据上得以处理。
- 第二,不太容易得到比较稀疏(Sparse)的答案(Solution)。
- FTRL - follow the regularized leader 参数在每一个数据点更新
- 第一部分是一个用过去所有的梯度值(Gradients)来重权(Re-Weight)所有的参数值;
- 第二部分是当前最新的参数值尽可能不偏差之前所有的参数值;
- 第三个部分则是希望当前的参数值能够有稀疏的解(通过 L1 来直接约束)
- 普通的逻辑回归并不适应大规模的广告点击率预估。有两个原因,
- GBDT + LR (Facebook, 2014)
- 点击率预估模型分为两个层次。也就是说,从最初的模型特性输入,需要经过两个不同的模型才对点击率做出最终的预测。这个两层架构对后来的很多点击率预估模型有巨大的影响。
- 连续数值的特性已经被转换成了离散的数值。然后,这些离散的数值经过了一个 GBDT 树来进行特性转换
- 第一,GBDT 可以对特性进行非线性组合。也就是说,GBDT 的输出一定是之前特性的非线性的转换,这是由树模型原本的性质所带来的,这个性质对于线性模型来说会有巨大的优势。
- 第二,经过 GBDT 转换之后,树模型其实选择出了对目标有用的特性,因此这里还起到一个“特性筛选”(Feature Selection)的作用。也就是说,经过 GBDT 的模型,最后剩下的特性肯定是要远小于最初的输入特性的,毕竟有作用的特性是少数的
- 连续数值的特性已经被转换成了离散的数值。然后,这些离散的数值经过了一个 GBDT 树来进行特性转换
- 点击率预估模型分为两个层次。也就是说,从最初的模型特性输入,需要经过两个不同的模型才对点击率做出最终的预测。这个两层架构对后来的很多点击率预估模型有巨大的影响。
- 特征交叉(LinkedIn, 2014)
- 第一部分,是利用用户、广告和上下文所建立的全局性预测。什么意思呢?就是我们利用用户特性、广告特性以及上下文特性来对点击率进行预测。这部分的核心思路就是这些特性所对应的系数是全局性的。也就是说,对于不同的用户、不同的广告以及不同的上下文所对应的系数是相同的。(泛化特征,解决冷启动)
- 第二部分,是利用第一部分的用户、广告和上下文信息组成交叉特性,从而学习这些特性之间的关系。如果说第一部分直接就是线性的预测,那么第二部分其实就是“交叉项”形成的非线性的部分。
- 第三部分,是 LinkedIn 模型提出来的独特之处(和其他公司模型不太一样的地方)。那就是同样是利用用户、广告和上下文特性,但是 LinkedIn 所提模型的系数则是每个用户、广告和上下文都不同。
- 排序模型(Twitter, 2015)
- 排序 + Calibration(保序回归)的架构
现状(2016~)
- 排序 + Calibration(保序回归)的架构
推荐模型和深度模型
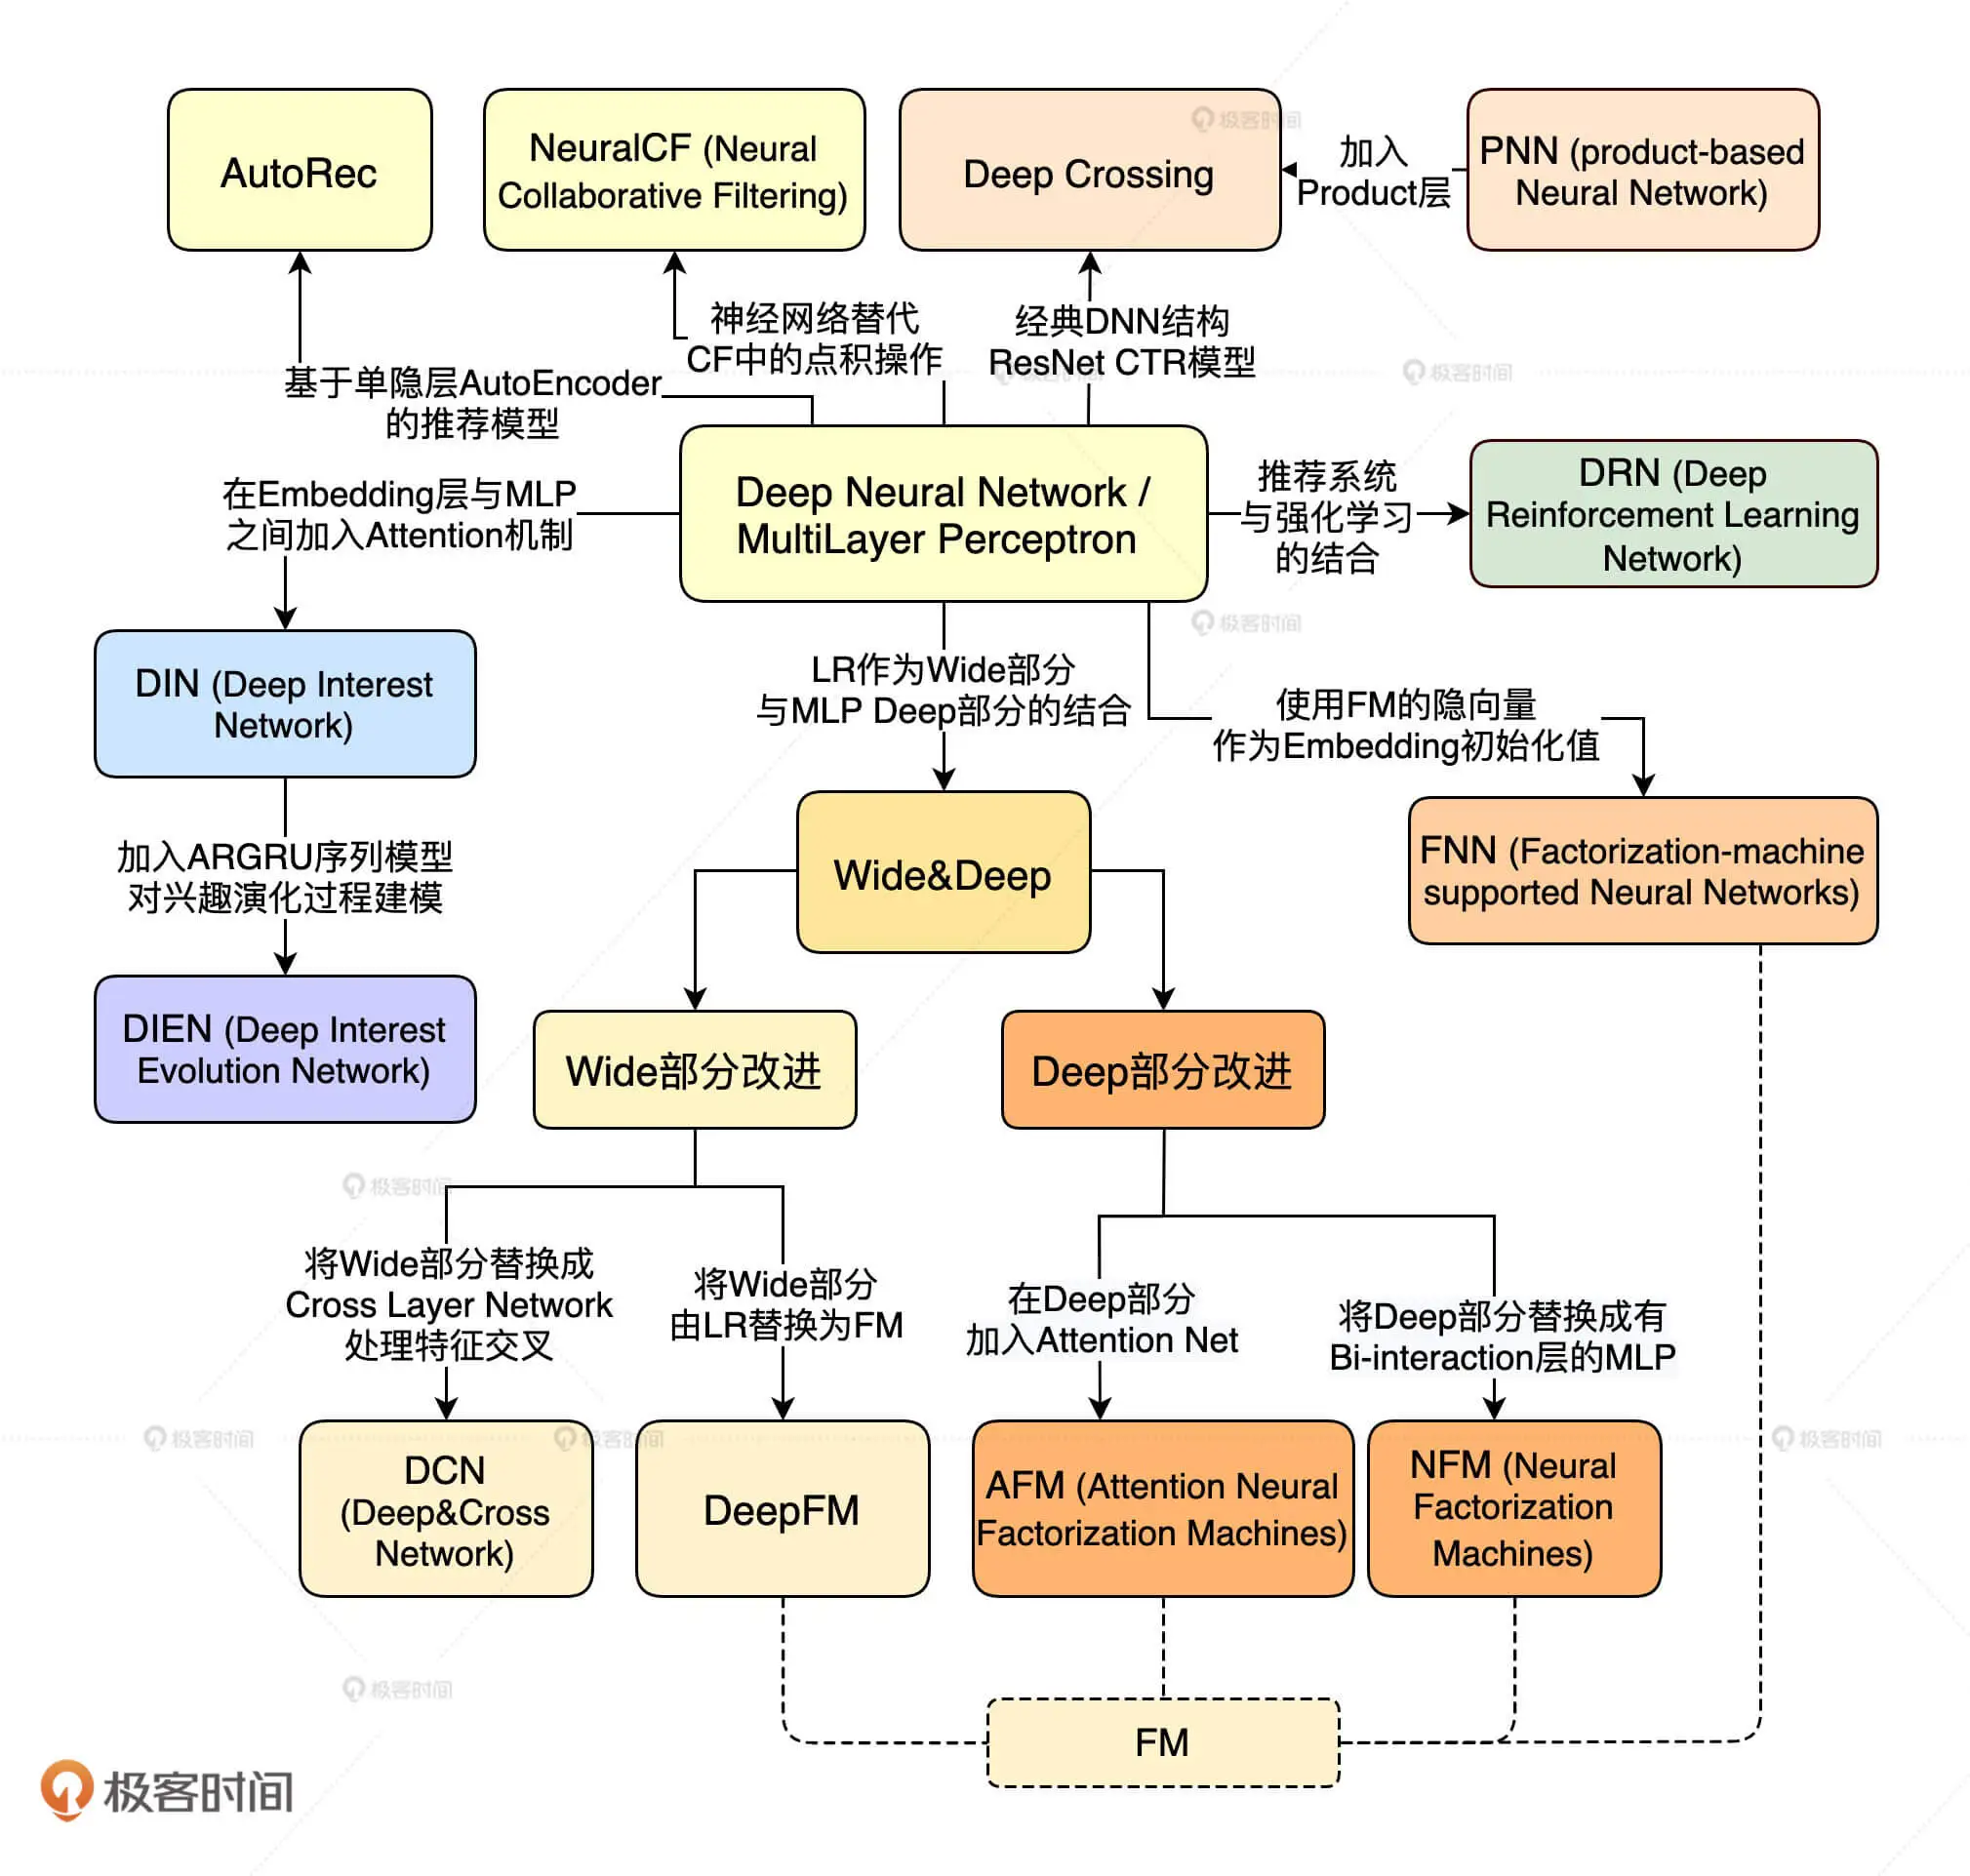
- 推荐模型基础:Collaborative Filtering (CF) -> Factorization Machine (FM)
- 矩阵分解的主要过程,就是先分解协同过滤生成的共现矩阵,生成用户和物品的隐向量(embedding),再通过用户和物品隐向量间的相似性进行推荐。
- Wide&Deep(Google, 2016):FM和LR手动设计特征的低阶组合,DNN 高阶特征的自动组合,组合起来 记忆&泛化
- 它把深层的 MLP 和单层的神经网络结合起来,希望同时让网络具备很好的“记忆性”和“泛化性”。
- 凭借着“易实现”“易落地”“易改造”的特点,获得了业界的广泛应用。围绕着 Wide&Deep 还衍生出了诸多变种,比如,通过改造 Wide 部分提出的 Deep&Cross(Google, 2017)和 Deep FM(Huawei, 2017),通过改造 Deep 部分提出的 AFM、NFM 等等。总之,Wide&Deep 是业界又一得到广泛应用的深度推荐模型。
- 基于deepFM+NFM,bias筛选进NN:deepFM(w&d中LR->FM),NFM(两两内积->element product,过NN +LR) --> All embedding:抖音精排点击模型ALL EMBEDDING
- DIN, DEIN(DIN/DIEN/DISN 阿里巴巴深度CTR三部曲 ) Position Aware DIN On AwemeAd CTR
- 它在神经网络中增加了一个叫做“激活单元“的结构,这个单元就是为了模拟人类的注意力机制。
- 举个例子来说,我们在购买电子产品,比如说笔记本电脑的时候,更容易拿之前购买电脑的经验,或者其他电子产品的经验来指导当前的购买行为,很少会借鉴购买衣服和鞋子的经验。这就是一个典型的注意力机制,我们只会注意到相关度更高的历史购买行为,而 DIN 模型就是模拟了人类的注意力特点。
- DIN 模型的改进版 DIEN 模型就更厉害了,它不仅引入了注意力机制,还模拟了用户兴趣随时间的演化过程。我们来看那些彩色的层,这一层层的序列结构模拟的正是用户兴趣变迁的历史,通过模拟变迁的历史,DIEN 模型可以更好地预测下一步用户会喜欢什么。
模型改进的4个方向
- 是改变神经网络的复杂程度。 从最简单的单层神经网络模型 AutoRec,到经典的深度神经网络结构 Deep Crossing,它们主要的进化方式在于增加了深度神经网络的层数和结构复杂度。
- Multi-Task资料汇总 Multitask模型实践指南
- LineId字段转换为FC入图
- LHUC(LHUC(Learning Hidden Unit Contributions, arxiv):LHUC模型结构调研 External Action aware CVR Modeling with LHUC
- SENET:头条CVR 模型加 SENET 结构
- 是改变特征交叉方式。 这种演进方式的要点在于大大提高了深度学习网络中特征交叉的能力。比如说,改变了用户向量和物品向量互操作方式的 NeuralCF,定义了多种特征向量交叉操作的 PNN 等等。
- Attn:西瓜CVR AutoInt distillation model
- 属于对特征交叉的改进,特征间带attention显式交叉有收益,但需要平衡模型效果和线上serving延时。distill:两部分loss,1)all embedding的slot embedding按长度对齐进AutoInt layer,做self attention,再经过上层NN;2)相同的embedding+NN
- 特征交叉:CDot Feature Compression and Dot Interaction Network (CDot)
- 把多种模型组合应用。 组合模型主要指的就是以 Wide&Deep 模型为代表的一系列把不同结构组合在一起的改进思路。它通过组合两种甚至多种不同特点、优势互补的深度学习网络,来提升模型的综合能力。
- 对比学习[LR]穿山甲冷路transfer learningTransfer Learning for Cold ads
- 迁移学习穿山甲闭环短视频transfer-learning
- 让深度推荐模型和其他领域进行交叉。 我们从 DIN、DIEN、DRN 等模型中可以看出,深度推荐模型无时无刻不在从其他研究领域汲取新的知识。事实上,这个过程从未停歇,我们从推荐系统顶会 Recsys2020 中可以看到,NLP 领域的著名模型 Bert 又与推荐模型结合起来,并且产生了非常好的效果。一般来说,自然语言处理、图像处理、强化学习这些领域都是推荐系统经常汲取新知识的地方。
精排策略
- 策略主要模块
- 引入客户生态价值、长期价值(客户和广告主LTV)干预排序
- 平衡探索 & 利用(EE策略)冷启动等
- 和混排结合 流量策略
精排的Calibration
- 和推荐不同,由于广告的精排预估不仅影响排序,还影响出价和计费(见下文、出价模块),因此广告的CTR、CVR预估要尽可能和后验接近
- 因此一般需要对精排预估值做”校准“(Calibiration), 弥补CTR的预估能力,常见的算法主要是保序回归,因为convert回流延迟问题,一般要结合对转化时间回流时间的预估模型进行
Reference
- Guo, C., Pleiss, G., & Weinberger, K. Q. (2017, June 14). On Calibration of Modern Neural Networks. In International Conference on Computer Science.
- OMKAR MURALIDHARAN,Using Empirical Bayes to approximate posteriors for large “black box” estimators
- LEE RICHARDSON & TAYLOR POSPISIL,Why model calibration matters and how to achieve it
- Gneiting, T., Balabdaoui, F., & Raftery, A. E. (2007). Probabilistic forecasts, calibration and sharpness.Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(2), 243 - 268.
重排/混排
- RecRank
- 主要使用规则系统进行推荐文章的排序,后续还会进行文章样式的选择。
- Ad Load Controller
- 在前一步返回的推荐列表中插入广告和相关卡片,需要满足相关间隔规则,同时考虑对于推荐指标的影响。这一步确定的只是广告位,并没有选定具体是哪一个广告。
- Auction
- 在已经确定广告位与推荐结果后,预估广告CTR和CVR,然后进行广告位置拍卖,从而确定投放的广告。这一步将主要是广告与广告之间的竞争,推荐的分数将不会再起到较大作用。
长期方向:增效竞价及与自然内容深度结合
- 使用Uplift竞价方法,通过比较广告展示(R = P(convert=1|send=1))与未展示(Q = P(convert=1|send=0))时的转化率,计算增量转化率 (Uplift = R - Q)。
- 目标与理念:以真实转化增量为依据,实现广告主与平台共赢,避免高估“本来就会转化”的用户。
- 竞价公式:
- 理想竞价:uplift × uplift_rank_bid
- 实际LR竞价目标:((uplift/2 + pvr/2) × rank_bid × bid_coef),其中 pvr 为基础转化率。
- 优势总结:该方法精准衡量广告真实增量,提升ROI及平台整体收益,同时兼顾双方利益。
出价
广告系统的拍卖和计费机制
- 大部分市场比如商品市场一般不需要特殊的机制设计,发挥作用的是价格机制,但不完全依赖价格机制的分配其实非常常见,比如肾脏移植、升学求职、online dating等双边市场。机制设计在现实中比较成功的应用是在肾脏移植、升学择校上。
- 在互联网环境下,广告资源的分配常借助拍卖模式进行。像搜索引擎的广告位、社交媒体的展示广告等,众多广告主竞争有限的广告曝光机会,如同传统拍卖中竞买者争夺拍品。广告平台将广告展示位置、展示时段等资源当作 “拍卖品”,广告主通过出价竞争这些资源,从而实现广告投放。拍卖的市场机制为广告系统提供了有效的竞争环境塑造方式。广告系统中,拍卖机制的引入促使广告主基于自身对广告效果的预期和收益评估来出价。
几种常见的计费机制
- 广义第一价格(Generalized First Price, GFP):和传统第一密封竞价类似,出价高者得,需支付自己提出的报价。
- 原理:一价计费,广告主报价即扣费
- 优势:逻辑简单
- 问题:广告主存在探价动机
- 广义第二价格(Generalized Second Price , GSP):和传统第二密封竞价类似,出价高者得,需支付出价第二者提出的报价(再加上一个最小值)。
- 原理:根据下一名的报价,决定计费值
- 优势:缓解了探价问题
- 问题:多广告位场景依然存在探价问题,不够极致
- 二价和增价拍卖都具有防策略性
- 防策略性(strategy-proof):不存在通过虚假报告而获利的可能(不会讲假话试探),即讲真话truth-telling是占优策略。
- 公平性(失败者不会羡慕获胜者)
- 二价和增价拍卖都具有防策略性
- VCG(Vickrey-Clarke-Groves):竞价获胜者需支付他产生的外部性,即他参竞对其他人造成的损失。
- 原理:因为竞价成功而给其他广告主造成的损失,决定计费值
- 优势:存在纳什均衡点,鼓励广告主说真话
- 问题:不容易理解
综合考虑,大部分广告平台采取GSP为计费机制
Reference
- 《合适:机制设计入门》
- 从初夜权到在线广告——拍卖中的趣味与玄机
- 《价格的发现》,https://book.douban.com/subject/35128229/
- 《斯坦福算法博弈论二十讲》,斯坦福算法博弈论二十讲 (豆瓣)
- 《拍卖理论》,拍卖理论 (豆瓣)
- clock auctions and radio spectrum realloction
出价点和计费点分离
竞价点和出价点的分离、出价点和计费点的分离
所谓竞价点 一般指send/show,即决定要出哪个广告的事件点,最早期只有CPM广告,一切都很简单,每个展示多少钱,每个广告对展示出价,排序最高的胜出即可。Google首创了CPC广告按点击出价*预估点击率来排序的方案,引入了模型因素,从CPM-CPC-CPA就顺理成章了。
竞价点比较特殊的一点是它比较固定的,无论何种计费类型,都需要投放系统来决定排序,所以要根据send/show的ecpm来排序。对cpc是点击出价预估点击率,对cpa来说是转化出价预估点击率*预估转化率。
从客户追求ROI的角度考虑,出价点越靠后越好,这样更接近客户考核的后端目标,客户更容易衡量ROI是否达成,但对平台来说就额外引入了风险,因为这些计费方式下 计费点和出价点是一致的,如果模型预估不准,会影响平台收入,这又分预估偏低和偏高:预估偏低的话 广告主没有拿到可以拿到的量,媒体收入变少,二者都受损;预估偏高的话,广告主拿到了很多展示不需要付费,广告主无所谓,但媒体损失了很多展示拿不到钱,就比较亏,这种情况下媒体有动力去估准,但广告主有动力不让低估。
这里面cpc和cpa还不太一样,点击行为发生在媒体里,媒体可追踪,但action不一定在媒体内部发生,很多应用下载类广告的出价点是激活或者付费,不是媒体可以直接获取的,这时广告主就有动力不回传真实数据来获利,虽然没办法长期获利(预估会偏低,但可以不断新建计划来薅羊毛),因此支持CPA计费方式的一般只有媒体侧闭环的转化目标,比如商品购买、表单提交等。但我们从去年底连这类转化目标的CPA广告也逐渐下掉了,原因是…超投的问题:竞价点和计费点相隔太远,导致平台很难控制超投,得不偿失。
o类广告:FB首创的计费点和出价点分离的计费方式,模型优化目标和计费点分离后,一方面可以尽量发挥模型的优势去优化更深的转化行为,另一方面平台可以在漏斗靠前的地方计费,减少了平台风险;同时,除了高估的风险外,客户的利益也有保障。
平台风险来自两部分:广告主作弊和预估不准确;从CPA到oCPC到oCPM,平台承担风险变小,广告主风险变大
| 计费方式 | 竞价点 | 出价点&模型优化点 | 计费点 | 模型需预估 | 超投风险 | 作弊风险 | 预估偏低 | 预估偏高 | 预算充足客户 | 预算有限客户 |
|---|---|---|---|---|---|---|---|---|---|---|
| CPM | show | - | show | - | 低 | 低 | - | - | - | - |
| CPC | show | click | click | ectr | 中 | 低 | 客户跑量减少,平台收益降低 | 客户跑量增加,平台收益降低 | 有动力提升ctr | 取决于中间指标和后端收益的关系 |
| CPA | show | convert | convert | ectr&ecvr | 高 | 高 | 客户跑量减少,平台收益降低 | 客户跑量增加,平台收益降低 | 有动力提升ctr/cvr | 取决于中间指标和后端收益的关系 |
| OCPC | show | convert | click | ectr&ecvr | 中 | 低 | 客户跑量减少,平台收益降低 | 客户跑量增加,平台收益不确定 | 有动力提升ctr/cvr | 取决于中间指标和后端收益的关系 |
| OCPM | show | convert | show | ectr&ecvr | 低 | 低 | 客户跑量减少,平台收益降低 | 客户跑量增加,平台收益增加 | 有动力提升ctr/cvr | 取决于中间指标和后端收益的关系 |
send/show计费有啥区别?差别不大,因为同一个广告位的ssr取决于用户行为,基本不受广告本身影响(素材类型会有一点点影响),不过按发送计费的好处是计费更靠前,超投的风险更低,预算花费可以做得更准,坏处是如果一个广告没展示其实并不能真的算是一个负例,从这个意义上讲,预估点击率时应该拆分发送到展示、展示到点击两步,因为第一步并不是这个广告的特征。
ADX(联盟广告)下GFP计费
业界一个主要的动向是RTB市场的ADX在全面转向公开bid信息的first price auction,包括google ad manager。注意这里的扣费指的是 ADX/媒体向DSP结算过程,而非向广告主结算的过程。
Google在2019-2021年期间将Ad Manager、AdMob、AdSense的广告拍卖机制从二价切换为一价,主要驱动因素如下:
An update on first price auctions for Google Ad Manager
关键原因
- 多轮拍卖效率优化
- 原二价机制在跨平台竞价时存在高报价广告主无法胜出的悖论(如ADX内部二价竞价后,需与外部一价竞价结果比较)
- 一价机制可避免多轮竞价策略冲突,统一竞价规则
- 行业竞争均衡驱动
- 当广告主基于平均结果出价时,一价成为各广告交易平台(ADX)的纳什均衡选择
- 广告交易平台间竞争导致一价成为市场自然选择
- 机制可信度提升
- 一价机制降低媒体作弊动机(如虚报二价)
- Google通过完全竞价透明度(公开获胜价)优化算法,强化平台可信度
- 技术架构变革适配
- 媒体从瀑布流(waterfall)转向头部竞价(header bidding)后,一价机制能提高清算价预期值
- 新机制使ADX服务同质化,买方侧费用趋近于零
与大媒体的自有流量不同,平台可以有统一且强力的控制机制,例如底价设置、防止伪造虚拟候选人等。
在联盟场景中,联盟平台要面向太多的媒体流量进行投放,每个媒体也会接入多个媒体变现平台(穿山甲、广点通等),因此竞价从来都是掌握在各个小媒体的手中。这对代表客户的投放平台来说本身就是黑盒的,小媒体有足够的动力研究如何设置底价,如果创造虚拟竞争者等让 GSP 实际上名存实亡,且这个过程中让整个竞价体系极其复杂,因此 GG 联盟于 2019 年切换成统一 GFP,各家媒体也都广泛使用 GFP,以降低竞价复杂性,提升竞价透明度。相关内容可参照谷歌转用首价竞拍机制_竞价,Simplifying programmatic: first price auctions for Google Ad Manager。
GFP 解决了流量侧的竞价透明度和简易性问题,但给平台的出价带来了一些困难。但在通投下,站内和站外流量下的不同的计费机制直接导致了无法采用统一出价的方式去优化
GSP vs GFP
- GSP能够保证只有平台、广告主竞拍前提下,广告主的truthful bidding行为。但如果考虑到媒体方的参与,GSP无法保证媒体方做出最有利于全局最优的选择(i.e. 他们可能为了利润返回虚假二价、设置专用于顶价的底价…)。
- 在GFP下,媒体方没有作弊破坏auction的动机,因此能够保证机制本身的公平性。
- 在RTB市场上广告主都会通过DSP参与竞价,DSP拥有足够的优化能力帮助广告主做bidding策略。
- 虽然是一价拍卖,但google会公开拍卖的各类信息(获胜价格),方便DSP去做探价优化
Reference
- Geradin, D., & Katsifis, D. (2019). ‘Trust me, I’m Fair’: Analysing Google’s latest practices in Ad Tech From the Perspective of EU Competition Law. TILEC Discussion Paper, DP 2019 - 029, October.
- ClearCode, How Do First-Price and Second-Price Auctions Work in Online Advertising?
- Despotakis, S., Ravi, R., & Sayedi, A. (2019). First - price Auctions in Online Display Advertising. Working Paper, November.
- Leme, R. P., Sivan, B., & Teng, Y. (n.d.). Why Do Competitive Markets Converge to First - Price Auctions?
- Akbarpour, M., & Li, S. (2019, June 21). Credible Mechanisms
- Conitzer, V., Kroer, C., Panigrahi, D., Schrijvers, O., Stier - Moses, N. E., Sodomka, E., & Wilkens, C. A. (2021). Pacing Equilibrium in First Price Auction Markets. Forthcoming in Management Science.
- https://www.gsb.stanford.edu/insights/rigged-auctions-why-top-bidders-dont-always-feel-winners
- https://www.adexchanger.com/online-advertising/auction-theory-ph-d-s-share-five-things-buyers-and-sellers-should-keep-in-mind-for-first-price-auctions/
- https://www.blog.google/products/admanager/simplifying-programmatic-first-price-auctions-google-ad-manager/
- https://support.google.com/admanager/answer/9298008?hl=en
出价产品
- 和排序不同,出价产品和策略更多是从客户视角出发,帮助客户实现最大化ROI和跑量;由于平台存在信息、数据等优势、越深的转化目标/自动化成都,平台帮助客户出价的优势越大
- 平台一般不会使用客户原始出价排序,而是把出价产品/策略耦合耦合在投放系统中
- 出价影响精排/混排排序, 简单来说,排序的目标是最优化 出价*转化(合理赚到的钱)
出价产品的设计
- 约束及目标:产品定位,对客户的保证,比如是控制成本下的最大消耗,还是保证预算花完下的最低转化成本;约束一般是要一定达成的,目标则是尽可能的好。
- 控制周期:对客户多长时间达成保证,比如是一天把预算花完,还是 7 天把预算花完,是每时每刻保成本,还是 7 天结束时保成本;
- 控制维度:在什么维度上为客户提供上述保证,一般对齐客户在什么维度上出价,是计划维度还是项目维度;
- 控制策略:是指策略的具体实现,比如是否是分流量下的统一出价(比如穿山甲和站内就不能统一出价,因为计费逻辑不一样),比如出价的控制算法(怎么实现上述目标的肯定是有多种算法的,比如 PID、MPC)。
不同组合下形成不同产品
| 产品名称 | 约束及目标 | 控制周期 | 控制维度 | 控制策略 |
|---|---|---|---|---|
| TargetCost(风控出价、控成本) | 自然天计费比为1(约束),最大化跑量(目标) | 自然天级别 | 计划/项目组维度 | MPC模型动态调整rankbid,根据实时计费比调节出价 |
| Nobid(流控出价、控预算) | 预算必须花完(约束),获得最低转化成本(目标) | 自然天级别 | 计划/项目维度 | 从低到高探索rankbid,结合预算分配曲线和MPC调整实现预算消耗与成本平衡 |
| CostCap | 平均转化成本不超上限(约束),尽可能降低转化成本(目标) | 自然天级别 | 计划/项目维度 | 动态调整rankbid以平衡成本与消耗速度(可能结合MPC或其他控制算法) |
| 控成本诉求 | 花预算诉求 | 产品名称 | 产品定位 | 适用场景 | 说明 | 评价指标 |
|---|---|---|---|---|---|---|
| 2 | 3 | Target Cost(手动出价) 包含优先跑量、均衡投放 |
尽可能优化平均转化成本,接近广告主设定的目标转化成本 | 1. 明确知道自己的平均转化成本 2. 希望平均转化成本稳定在出价附近 |
1. 预算可能花不完 2. 天与天之间的消耗不稳定 |
1. 计费比: a. 完成档(0.8-1.2),问题档(>1.2) 计划占比,消耗占比 2. 掉量率 3. 跑量 📝MPC准全实验评估-商业数据科学 |
| 1 | 4 | Cost Cap(手动出价) 控制成本上限/优先低成本 |
尽可能降低转化成本,尽可能优化平均转化成本不超过广告主设定的成本 | 1. 想要尽可能低的平均转化成本 2. 希望控制平均转化成本的上限 |
1. 预算可能会花不完 2. 天与天之间的消耗不稳定 3. 平均转化成本可能会不稳定 |
1. 产品完成率: 完成档:天级预算使用率 > 50% & 计费比不超过1.3*cpa_bid |
| 3 | 2 | Dynamic Cost Cap(自动出价) 放量投放 |
在保证一定消耗水平的情况下,尽可能降低平均转化成本 | 1. 知道自己的平均转化成本,想要尽可能低的平均转化成本 2. 为了一定的消耗稳定,愿意接受更高的平均转化成本 |
1. 预算可能会花不完 2. 天与天之间的消耗不稳定 3. 平均转化成本可能会不稳定 |
1. 产品完成率: 完成档:天级预算使用率 > 50% & 计费比不超过1.3*cpa_bid |
| 4 | 1 | No Bid/lowest cost 最低转化成本 |
在花完预算的前提下,尽可能提升转化数(降低平均转化成本) | 1. 想要以最低转化成本花完所有预算 | 1. 无法控制平均转化成本 2. 天级转化成本可能会波动 3. 计划生命周期波动时成本可能会变高 |
1. 产品完成率: a. 完成档:天级预算使用率 > 90% & 天级成本波动在-35%以内 b. 问题档:天级预算使用率 < 50% & 天级成本波动在+50%以上 2. 相同消耗量级下,nobid成本不应远高于其他出价产品(影响客户留存) 📝Target Cost vs Nobid 成本对比实验-商业数据科学 |
出价策略
实现出价产品目标的策略
- 风控出价
- 目标:通过PID调控动态调整出价,确保广告主成本不超支
- 方案:基于后验计费比反馈,动态调整RankBid(
RankBid = 广告主出价 + cpa_bid * (1 + PID参数)) - 评估:计费比在区间[0.8, 1.2]的计划占比、消耗占比
- 流控出价
- 目标:控制预算消耗速度,实现预算均匀分配
- 方案:结合大盘流量曲线全局分配预算,PID调控出价(
RankBid = 广告主出价 / 2.0 + cpa_bid * (1 + PID参数)) - 评估:计费比达标或预算使用率>90%的计划占比
- 双出价
- 目标:同时满足双成本约束(如前端+后端成本),最大化跑量
- 方案:
- 一期:
ecpm = min(前端PID出价, 后端PID出价 * 超参数) - 线性融合:将前后端成本作为约束,最大化广告主价值
- 一期:
- 评估:前端计费比<1.0且后端计费比达标的计划占比
- 其他出价
- 深度转化Pacing出价:保前端成本同时优化后端转化率(
ecpm = cpa_bid * ctr * cvr * deep_cvr * 系数) - 广告变现Uroi:结合ROI目标和LTV预估动态出价(
ecpm = min(预估LTV / ROI目标, 2 * cpa_bid))
- 深度转化Pacing出价:保前端成本同时优化后端转化率(
- QCPX(激励和广告结合等策略)
- 电商、激励、线索等场景下,通过实验/模型预估用户对于激励的反应(Uplift)实现对流量差异化定价(Price Discrimination)、刺激用户消费
- 拍卖中,平台通过差异化计费、和广告主共同承担激励成本
出价算法
- 最优化:
-
- 对于加速投放来说,存在一个最优的出价,风控bid全天是统一的,使得在计费比=1下,消耗最大化;
- 同样,对于no-bid出价,也存在一个最优的出价,流控bid全天统一,使得在预算花完情况下,转化数最大化;
- 对于优先低成本,因为是同时存在计费比和预算约束,最优出价是min(风控, 流控)
-
- 预估转化:无法拿到实时转化、要根据预估转化来实现出价
- 控制算法
- PID控制算法
- 比例控制(P):基于当前误差按比例调整,易导致系统震荡
- 积分控制(I):累积历史误差消除稳态偏差,使输出最终稳定
- 微分控制(D):预测误差变化趋势,提前抑制超调,提升响应速度
- 应用场景:广告风控出价调价、预算消耗速度控制(流控)
- MPC控制算法
- 核心机制:通过实时预测未来输出轨迹,滚动求解带约束的优化问题
- 关键特点:
- 采用预测模型动态更新参数(非固定参数)
- 每次仅执行优化序列的第一个控制量
- 天然支持多约束条件处理
- 优势:解决PID滞后性问题,适应复杂时变系统
- 应用场景:需处理多目标约束的智能调价场景(如双出价)
- PID控制算法
- 优化系统Variance
- 模型优化,增强泛化能力,减少预估varaince
- 策略优化、和广告主复制的计划、创意等博弈
- 全链路控制:调整出价会影响全链路、打通统一控制
Reference
- 深度学习推荐系统
- 计算广告