当本体从"描述世界"
跨到"驱动世界"
大模型能写诗、能编程、能通过律师资格考试——但为什么没人敢让它独立审批一笔一百万的跨境转账?这份 deck 用一个四十年的故事回答这个问题:OWL 让机器理解世界,知识图谱让机器检索世界,而 Palantir 的本体,让机器在你划定的规则里改变世界,并随世界一起进化。
为什么不敢让 AI 批一百万?三宗罪,和一只"笼子"
在写作、翻译这类容错场景里这些毛病无伤大雅;一旦进入法律、医疗、金融、生产调度这些高价值、强合规的场景,它们就是致命伤。
- 幻觉一本正经地编造不存在的事实
- 不可控同一个问题问两次,推理路径可能南辕北辙
- 不可审计出了事,没法回答"当初为什么放行"
行业的解法出奇一致:给 AI 套一个"语义笼子"
工程语境下的本体论,不再是哲学追问,而是一件很具体的事——领域的语义 Schema。一个电商风控本体至少显式写清三样东西:
- 概念:什么是"用户"、"风险"、"订单"
- 关系:用户 → 下单 → 订单
- 规则:金额 > 10 万的订单,必须走风控审批
用确定性的知识,给概率模型套上一根缰绳。模型想"自由发挥"跳过风控?规则不允许。
先打一针疫苗:"本体论"这个词,正在被四种方式滥用
当五个人同时说"我们要上本体论",他们说的很可能是五件不同的事——每个人摸到的是大象完全不同的部位,却都坚信自己摸到了全部。
① 概念混淆
哲学派、知识图谱派、技术标准派(OWL/SHACL)、产业应用派(数据语义层)、AI 架构派(多智能体共识)——五大流派用同一个词指代完全不同的东西,讨论从一开始就错位。
② 局部宣称全局
知识图谱专家说它能解决所有 AI 推理,RAG 工程师说它能彻底消灭幻觉,智能体研究者说它是多智能体的唯一出路。每一种都局部有效,但没有一种能单独解决 AI 的全部问题。
③ 落地碎片化
学术界钻研 OWL、描述逻辑,门槛高、路径模糊;大厂各自为政,内部体系互不兼容成技术孤岛;中小企业常把一张 ER 图改个名就当本体论卖。
④ 刻意淡化成本
营销话术绝口不提本体"重、慢、贵":构建要行业专家与技术专家深度协作数月;业务逻辑一个微小变动就可能引发大规模重构;大量场景下,轻量级 Schema 加提示词工程反而性价比更优。
任何只谈"智能"不谈代价、只讲"万能"不讲边界的本体论叙事,都值得打个问号。
四十年,三种本体:生于三个不同的时代与痛点
- ①1980 年代 · 知识工程期本体作为 AI 知识表示工具诞生;Tom Gruber 1993 年定义"概念化的显式规范"。局限刻在基因里:人工输入、封闭系统、扩展有限
- ②1997–2009 · 语义网标准化期RDF、OWL、SPARQL 成为 W3C 标准;Berners-Lee 把 Web 从"文档互联"推向"数据互联"。产物仍是静态知识图谱,以读取为中心
- ③2010 年代后期 · 局限暴露期IBM Watson 医疗失败让行业看清鸿沟——静态知识推理接不上实时运营;Google 从 OWL 路线转向实用主义知识图谱
- ④2010 年代中期至今 · 操作本体转型期把"动作"与"决策捕获"集成进动态数字孪生;理论根基是 Grieves 的数字孪生概念,代表作 Palantir Ontology
| 诞生背景 | 要解决的核心痛点 | 留下的缺口 | |
|---|---|---|---|
| OWL(语义网本体) | 源于 AI 知识表示与知识工程,语义网运动 | Web"机器可读但不可理解"——让机器能推理复杂知识 | 只描述与推理,不驱动业务动作;构建重、扩展难 |
| 知识图谱 Schema | Google 2012 年提出并应用 | 搜索引擎"关键词匹配"的局限——让机器理解事物关联 | 弱约束、重检索,推理与执行能力都弱 |
| Palantir Ontology | 2016 年 Palantir Foundry 发布 | 企业"数据烟囱"、决策滞后、技术业务脱节、缺乏自动化闭环 | 正是为填补上面两个缺口而生 |
OWL 和知识图谱的终点都是"回答问题"——它们描述世界,却不改变世界。企业真正的痛在描述之后那一步:分析出"这台设备该修了",然后呢?还得有人手动切到工单系统、填表、派单。Palantir Ontology 出现的全部理由,就是跨过这道断层。
What · 三种本体,三种世界观
法典、地图、可以按的按钮——不理解 OWL 和知识图谱各自的取舍,就无法真正理解 Palantir 到底"离经叛道"在哪里。
- OWL:让机器理解
- 知识图谱:让机器检索
- Palantir:让机器行动
- 直线 vs 圆圈
第一种 · OWL:一部逻辑严密的"法典",让机器理解
目标是构建一个让机器能推理的、无歧义的知识框架。你只声明了"父母",它替你算出了所有"祖孙"。
四大要素
- 类 Class领域核心概念:
Person、Disease、Drug——类似 OOP 的"类"或数据库的"表" - 属性 Property数据属性(
hasAge)描述特征;对象属性(treats)连接不同类 - 约束基数(恰好两个亲生父母)、值域(年龄 > 0)、不相交(
Man与Woman无交集) - 推理规则OWL 的灵魂。声明
hasParent传递,或写 SWRL 规则,推理机(HermiT、Pellet)扫描全库自动推导新关系
hasParent(?x,?y) ∧ hasParent(?y,?z) → hasGrandparent(?x,?z)
一个常被忽略的设计前提
- 开放世界假设(OWA):没写进知识库的信息不算"假",只算"未知"——擅长在不完备知识上推导,却让"校验数据合不合规"变得别扭
- 为此 W3C 专门制定 SHACL:封闭世界、验证导向,专管"数据长得对不对"。一个管推理、一个管验证——经典本体栈里,"描述"和"约束执行"从来是两套分开的机制
- 自上而下、专家主导:领域专家出概念规则,知识工程师翻译成 OWL;追求"小而精"
- 代价:构建成本极高、维护困难、海量动态数据扩展性差——所以 GO 基因本体、SNOMED CT 临床术语这类行业标准用它,很少有人拿它扛线上业务
OWL 让机器理解世界——它关心的是"逻辑上能推出什么"。
第二种 · 知识图谱:一张巨大的"关系地图",让机器检索
工业界的定义直白得多:一个实用的、可伸缩的类型标签系统,用来组织大规模、不完美、且持续变化的数据——"不完美"三个字是它和 OWL 最大的气质差异。
对现实的不完备性极度宽容
- 弱约束不强制所有"人物"都填"出生日期",否则数据根本进不来
- 允许缺失刚上映的电影,可以暂时没有"总票房"
- 容忍矛盾百科 A 说生于 1900、百科 B 说 1901——同时收下,留待后续融合
知识图谱让机器检索世界——它关心的是"图里能查到什么、能补全什么"。
构建与推理都和 OWL 相反
- 自下而上、自动抽取:NLP 从海量文本抽实体关系(信息抽取)→ 对齐已有知识库(实体链接)→ 归纳类型体系(Schema 归纳)
- 数据驱动的统计推理,不追求逻辑必然:路径排序(PRA)、图嵌入(KGE,核心假设
h + r ≈ t)、简单传递规则——都是"大概率成立"而非"逻辑上必然" - 追求"大而全":覆盖海量实体、毫秒级关联检索。Google 知识图谱、电商推荐、智能问答背后都是它
第三种 · Palantir:一套"能按按钮"的业务模型,让机器行动
它不只定义"客户是什么",还定义"能对客户做什么"(发起信用检查、发营销邮件),以及这些动作如何被自动触发、如何回写到 ERP、如何被审计。
| 维度 | OWL(语义网本体) | 知识图谱(KG) | Palantir Ontology |
|---|---|---|---|
| 建模逻辑 | 严格形式化逻辑、公理约束 | 以图论为基础,重节点与边的存储 | 以业务为导向的语义对象建模 |
| 构建方式 | 领域专家手工自上而下,门槛高 | 半自动化抽取 + 人工校对 | 业务建模器拖拽配置,易迭代 |
| 推理能力 | 强逻辑推理,基于公理 | 较弱,重图路径查询与检索 | 函数计算 + 事件触发 Action |
| 规模风格 | 小而精,追求严谨与标准化 | 大而全,覆盖海量实体与关联 | 适配业务系统规模,重多源融合 |
| 典型用途 | 行业标准、医学术语库 | 智能搜索、问答、反欺诈 | 企业数据语义层、流程自动化、情报分析 |
"这不就是知识图谱加了个自动化脚本吗?"——如果只是在 KG 上挂几个触发器,批评成立。但它把"可执行"和"会演化"做成了架构层面的三层结构,不是应用层的补丁(How 部分展开)。
学术界:"按 Gruber 的定义这根本不是本体。"诚实答案:两边都对——"本体"经过四十年语义漂移,学术派守住词源(描述性知识表示),Palantir 重定义用途(操作性数字孪生)。真正要紧的是下一页那条结构性差异。
真正要紧的分野:直线答完即止,圆圈越用越准
能力谱几乎互为镜像
- 静态逻辑推理与知识共享——经典本体碾压
- 实时操作与数据写入执行——操作本体碾压
不是谁取代谁,而是互补:需要行业级语义标准时用前者,需要驱动业务闭环时用后者。三种取舍——理解、检索、行动。选错了,不是做得好不好的问题,是南辕北辙的问题。
How · 语义怎么变成"可执行、会演化"的系统
先认识舞台(Foundry 五步闭环),再看三层架构、五大要素、底层存储的真相,和一次想清楚了的取舍——物化,而不是虚拟。
- 舞台:Palantir 与 Foundry
- 三层架构
- 五大要素与存储真相
- 物化 vs 虚拟
- 零代码五步
- 端到端案例
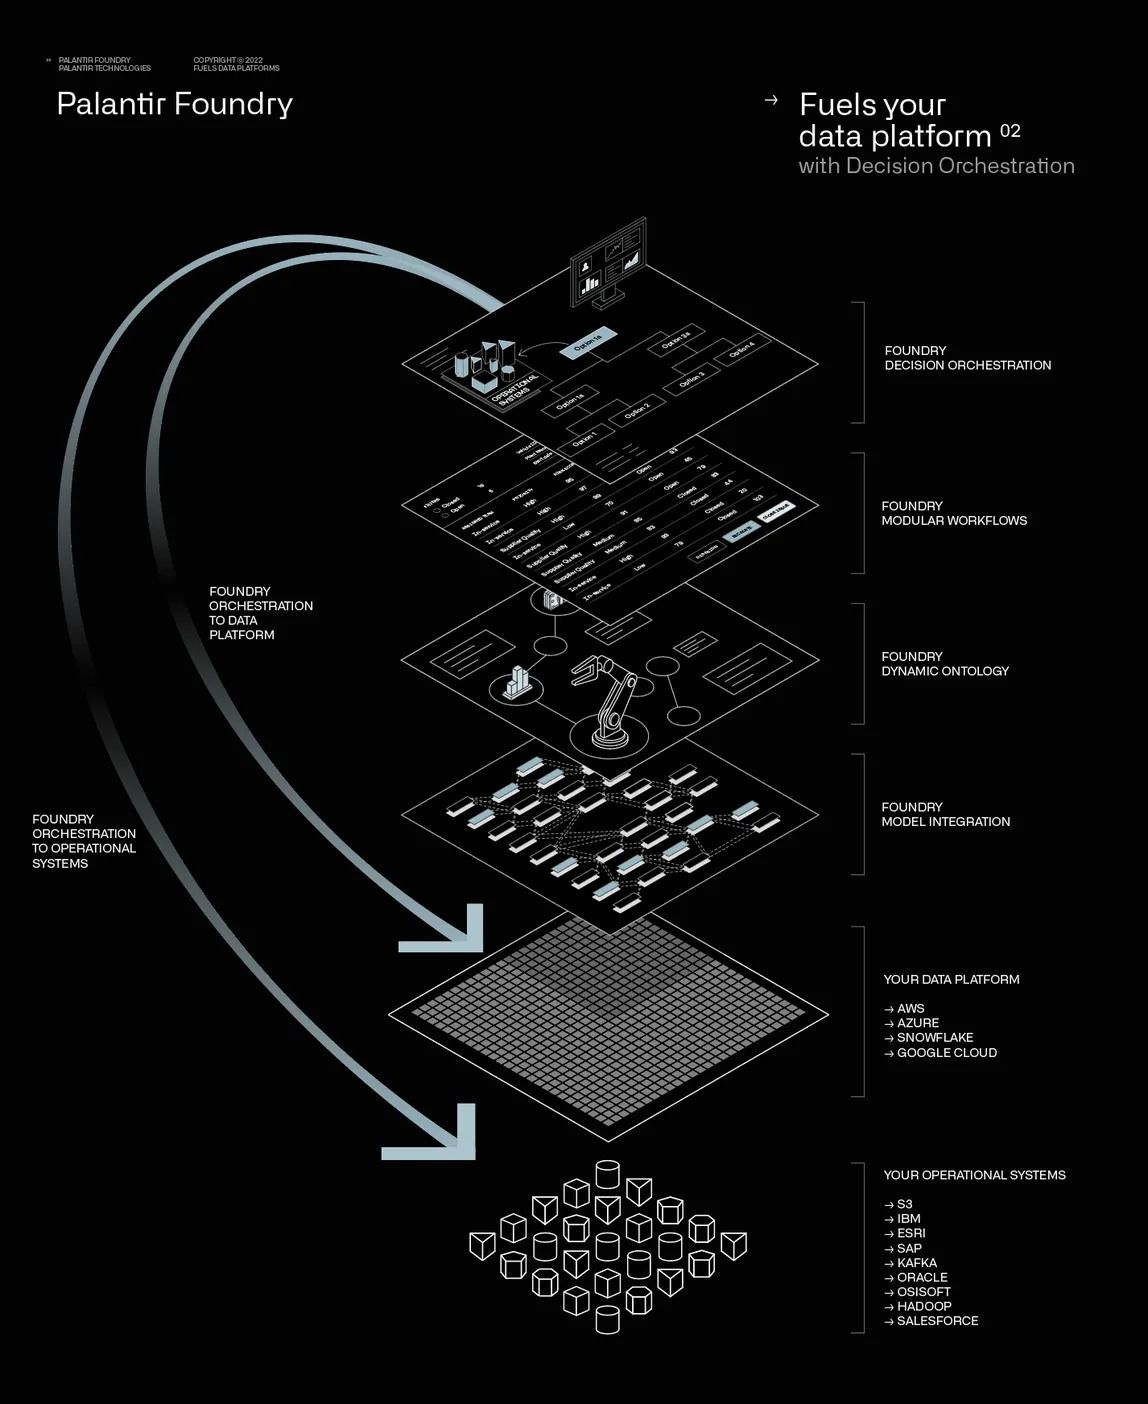
先认识舞台:Palantir 与 Foundry,数据到价值的五步闭环
Palantir 成立于 2003 年,名字取自《指环王》的"真知晶球";2005 年成为 CIA 的软件供应商。两款核心平台:Gotham(政府/国防,逻辑是"找点"——在通话记录、卫星图像、线人报告里发现隐藏关系网,O-R-E 模型)与 Foundry(商业企业,逻辑是"建模"——把杂乱数据铸成标准化资产,Object/Link/Action/Function 模型)。
企业操作系统三件套
- Foundry内核(数据与操作)——Ontology 是它的"对象模型"
- AIPAI 运行时(第四节的主角)
- Apollo更新机制——前两者合计 300+ 微服务跑在自动伸缩计算网格上,每周编排数万次发布
本体(MODEL)是这条链的中枢;而它自己,又由三层构成——下一页。
三层架构 = 三个层层递进的问题
语义层答"世界是什么"(治数据看不懂),行为层答"我们能做什么"(治数据用不了、改不了),动态层答"世界如何演化"(治规模大了就得推倒重来)。
语义层:"活字典"的每个词条都带着类型、约束和权限
Foundry 类型系统分两族:Ontology types(对象/属性/共享属性/链接/动作/接口)管领域建模;Data types(字段/基础/值类型)管值的表示——语义直接借鉴 RDF/OWL/XSD 语义网标准。
- 类型≠实例对象类型是纯元数据不含数据值——
Airport是类型,JFK是实例;link type 是关系模式,link 是"Melissa Chang → Acme, Inc."这一条(官方类比:两数据集 join 后的单行) - 共享属性"创建时间/状态/优先级"集中定义、多处引用,改一处全体同步——DRY 在类型系统层的落实
- 接口按能力切分的契约:
Inspectable、SchedulableResource——面向接口写的调度流无需修改就适用于会议室、场馆、车辆(组合优于深层继承)。接口可定义 Action,但只能改共享属性,且任何 Action 都不允许改主键 - 值类型把 string 包装成"电子邮件地址/UUID"并附约束——"年龄>0"变成可复用资产
- 自反关系
Employee上"直接下属 ↔ 经理"——组织层级、BOM 父子件全靠它
派生属性只作用于直接链接对象:Budget→Customer→Orders 隔一跳的聚合没法直接派生——写 Function 做"内部跳转",或适度反规范化。社区共识:业务语义优先,高频展示场景可适度铺平。
"活"不是魔法,是管道
| 维度 | 语义层(图模型) | 传统数据库 Schema |
|---|---|---|
| 数据同步 | 实时动态投影,底层变化即时反映 | 静态定义,依赖 ETL 批量同步 |
| 灵活性 | 易修改扩展,与底层存储解耦 | 修改成本极高,可能服务中断 |
| 数据形态 | 统一的关联图模型 | 分散表结构,关联隐式存在 |
- 每个对象类型挂支撑数据源:批管道 / 流管道(低延迟)/ 直连;多对多链接的数据源挂在链接类型自身上
- 增量索引(OSv2 默认开启)只处理变更——"底层一变、模型即时反映"的工程含义
- 安全是类型系统的一部分:MDO 多数据源对象(列式像 join:联系方式来自公开目录、薪资来自受控 HR 库,属性级切开;行式像 union:各区域供各的行);受限视图做行级权限并继承到对象实例——代价:严格只读、不能作下游输入、禁止外同步
于是业务人员能直接问:"过去 24 小时内,状态为'待维修'且位于'上海工厂'的设备的平均振动值"——系统自动解析对象、条件、聚合。
行为层:真正分道扬镳的地方——"只读模型"变"可执行模型"
官方把本体元素二分为语义元素("是什么")与动力学元素("能做什么")。传统数据模型只有前者。核心是 Action Type:Equipment.CreateMaintenanceTicket、Transaction.ApproveTransaction。
① ACID 事务保障
全成功或全回滚,不留中间状态。OSv2 给"批量"一个确切边界:单次 Action 最多编辑 10,000 个对象。
② 双向映射(以 SAP 为例,机制相当具体)
写回经远程使能函数(通常是 BAPI)执行;用户驱动的写回走 OAuth 2.0 授权码流程——SAP 侧每个操作都归因到具体用户,安全、许可证合规、审计三件事都系在这个归因上。反向读同步靠 SLT 复制服务器做 CDC:首次全量、之后只捕增量,不冲击生产系统。
③ 权限 · 审计 · 血缘
RBAC + ABAC 精细权限(ApproveTransaction 可能只对"财务经理"可见);不可篡改审计日志(谁、何时、什么参数、成败);自动生成数据血缘。
四种触发方式
- 属性变化设备温度超 80℃
- 函数结果风险评分超 90 分
- 定时每天凌晨 2 点
- 手动客服点击"创建工单"
驱动逻辑是全谱系的
业务规则、传统 ML 模型、优化器、LLM、跨引擎链式计算——都能挂进来当 Function 用(服务端形态 Functions on Objects,TypeScript/Python 编写)。
"分析出哪些设备要修"和"直接点一下就派出工单"之间,那道人工断层消失了。
动态层:让系统"自己长大",而不是"推倒重来"
传统系统的诅咒:GB 涨到 PB、10 人涨到 10 万人,架构扛不住只能推倒重构。动态层是为破诅咒而生的自适应演化层——既是免疫系统(抵御变化),又是进化引擎(驱动演化)。
管四件事
- 本体迭代据数据/反馈/业务变更自动或半自动更新语义层——发现高频搜索某"长尾"字段,建议转成标准属性
- 动作优化发现 90% 审批同一角色通过 → 建议"自动批准";高频失败动作做根因分析
- 规则演化从历史数据挖新规律生成预警规则、按季节动态调阈值
- 兼容性保障命脉所在:版本共存、自动迁移、弃用警告、灰度发布
听着像愿景?产品里有具体对应物
- Global Branching 管结构演化:Schema 变更(新增对象类型、改属性定义)先开分支、隔离测试、验证后合并主干,零停机;互补的"本体场景(Scenarios)"管数据层面的沙盘推演
- Schema 迁移:OSv2 支持破坏性变更后,把存量用户编辑迁移过去而不是丢弃
- 版本化记录"语义状态"而非行级快照:关系的建立与解除、实体身份的合并与拆分、置信度更新。国防本体里每条断言带 1–5 级标准化置信度 + 来源系统 + 报告位置与时间戳——所以能"回到任意时点,看当时知道什么",这是决策回溯与审计合规的根基
本体从需要人工维护的静态模型,变成会自我进化的"活的数字孪生"。
五大原子要素,与一个最该警惕的误解:Object 不是一张 MySQL 表
- Object业务"名词":
Customer、Equipment - Property对象"特征":
name、temperature - Link对象"关系"——是图数据库的边,不是外键:独立边集合,动态新增、临时关联、多跳穿透。"窦靖童的爸爸的前妻的前夫",外键 JOIN 写到崩溃,图的边是原生操作
- Function对象"计算能力"——编译成 AST 由内置规则引擎调度;三种触发(On-Change / On-Query / Scheduled);结果缓存为"虚拟属性",依赖一变缓存自动失效。例:
故障风险分 = 实时温度×0.6 + 维保逾期扣分×0.4 - Action对象"行为能力"——必须挂载对象,触发最常来自 Function 结果;典型链路 Property → Function 算风险 → 达阈值 → Action;每次执行进"动作执行时序流水表",全链路可审计
串起一切实例的是 RID(Resource Identifier):每行领到全局唯一、终身不变的 RID;链接靠源/目标 RID 成边;"对象集"本质是一组 RID——静态存主键列表,动态存过滤器(新数据命中自动纳入),临时对象集 24 小时过期。
官方拆解:Language / Engine / Toolchain,六个微服务,一组硬数字
官方明说它"不是薄薄一层语义层,而是数十个底层组件构成的多模态系统"。读写路径分开不是画法巧合,而是 OSv2 的立身之本。
- Language声明式建模语言:语义的对象/链接/属性(名词),动力学的动作/自动化(动词),加动作如何执行的逻辑片段
- Engine运行时。读:高规模 SQL、实时状态订阅、人机混合物化;写:原子持久事务、批量变更、流处理、对外部系统极低延迟镜像的 CDC
- ToolchainOSDK(TypeScript/Python/Java 程序化访问)+ 生产级治理的 DevOps 工具
OSv1 → OSv2:后端自己也"推倒重来"过一次
- OSv1(Phonograph):索引/查询/编辑耦合的单体,规模上限低——恰好印证动态层要解决的问题
- OSv2 从第一性原理重建:索引与查询子系统解耦、各自水平扩展;OSv1 已于 2026-06-30 弃用,存量需官方迁移工具切 v2
| OSv2 的代差数字 | |
|---|---|
| 增量索引 | 默认开启(只处理变更,不全量重刷) |
| 规模 | 单类型数百亿对象 · 每类型至多 2,000 属性 |
| 批量边界 | 单次 Action 最多编辑 10,000 对象 |
| 权限 | 对象级 → 属性级(MDO 的基础)· 原生流式低延迟索引 |
| Search Around | 多跳展开跑在 Spark 上,默认 100,000 对象上限 |
物化,而不是虚拟:一个想清楚了的架构取舍
直觉的答案是虚拟化:数据留在原处、查询时联邦(Timbr 把本体建模编译成优化 SQL 下推源库执行;dbt MetricFlow、Cube 也是查询时生成 SQL 的只读逻辑层)。Palantir 恰恰选了相反的路。
| 维度 | 虚拟语义层(Timbr/dbt 式) | 物化索引层(Palantir) |
|---|---|---|
| 数据位置 | 留在源库,零迁移 | 索引进对象数据库 |
| 查询性能 | 取决于源库负载与优化器 | 稳定低延迟,与源负载解耦 |
| 新鲜度 | 查询时实时 | 取决于管道 / CDC 同步频率 |
| 源系统故障 | 查询跟着不可用 | 读取不受影响 |
| 写回能力 | 基本只读 | 原生 Action 受控写入 |
| 成本 | 无集成步骤、低存储 | 集成强制、存储加倍、锁定加深 |
因为反复出现的那个词:行动。只读可以虚拟,行动不能——受控写入路径、事务保证、亚秒级读取、AI Agent 高频访问不把生产 ERP 打挂,都要求一个自己说了算的存储与索引层。虚拟化优化"描述世界"的成本,物化优化"改变世界"的可靠性。
注:PuppyGraph 的定性"heavily materialized and indexed layer"技术上准确;Timbr 材料里"Palantir 封闭、全有或全无"出自竞对营销,单方立场,读时打折。
物化的前提:数据得进得来、对得上——实体解析三板斧
进得来靠数百种预构建连接器 + 批/流/CDC 管道;对得上靠实体解析——把跨系统描述同一实体的多条记录合并成"黄金记录"。
- 确定性匹配靠身份证号、工号等唯一 ID 精准匹配——准确率 100%,但覆盖不了没有统一 ID 的长尾数据
- 概率性匹配没有唯一 ID 时,分析姓名、地址、电话的相似度(TF-IDF、余弦相似度、随机森林),算出"是否同一实体"的置信度得分——补上确定性匹配的盲区
- 幸存者规则同一实体信息冲突时的仲裁逻辑(如"以最近更新的系统为准"),确定最终黄金记录
国防场景里更进一步
- 多数据源对象把社交媒体账号、海关护照号、企业注册记录合并成同一个
Person - 每条断言带 1–5 级置信度和完整溯源(来源系统、位置、时间戳)
- 统一对象保留全部来源链接——受制裁实体横跨司法辖区与语言的空壳公司网络,就是这样被自动浮出水面的
连接器管"进得来",实体解析管"对得上",Funnel 物化管"读得快、写得回"——三者共同支撑上一页的取舍。
全程零代码:五步搭一个本体(Ontology Builder)
100% 可视化拖拽 + 表单配置,构建顺序恰好是对象 → 属性 → 关联 → 函数 → 动作。业务人员在界面上"画"实体、"连"关系;平台自动生成元数据、建图的节点与边、分配存储、调度计算。
- ①定义 Object从
books.csv映射"图书"实体;系统自动推荐book_id为主键 - ②添加 Property拖字段(书名、价格),或手动加(库存状态,枚举:在库/已借出/已售出)
- ③建立 Link按
author_id关联"图书-作者"为written_by,基数 1:N - ④编写 Function
价格 × 0.8算出虚拟属性"折扣价" - ⑤创建 Action
Mark_As_Sold:更新数据库 + 发通知邮件 + 调/api/inventory/reduce减库存
同一套模板跨行业复用,差异只在两处
- Function 的复杂度:条件匹配 → 多因子加权 → ML 推理
- Action 的闭环类型:金融风控是"风险分 > 90 且命中制裁名单即
Block_Transaction"的阻断型;电力预测性维护是"故障概率 > 70% 自动建工单派工程师"的执行型 - HyperAuto(软件定义数据集成)对 SAP/Oracle 这类结构化源:自动推断外键、字段语义、实体边界,数分钟映射成类型化对象与关系边(传统手动以月计);源表变更时映射增量更新——Lowe's 全球供应链数字孪生就是这么长出来的
其一,自动映射准确率仍需人工验证:跨表计算字段、非标准编码要手动补。其二,"折扣价 = 价格 × 0.8"当然零代码,但多因子风控评分、调用外部 ML 模型的 Function 大概率还是落回代码——零代码覆盖建模主干,不覆盖全部逻辑复杂度。即便如此方向成立:懂业务的人不再是旁观者,而能直接主导建模。
一个贯穿三层的端到端案例:设备预测性维护
看清第 5、6 步发生了什么:系统不是一次次修设备,而是从修设备的历史里学会了"这个型号本身有问题",然后改写了自己的模型。
第 ⑥ 步的两条虚线(青色)
- 语义层长出新属性:
modelVulnerability(型号缺陷) - 行为层长出新策略:
ProactiveReplacement(主动更换)——下次同类问题在爆发前就被主动处置
OWL 和知识图谱能描述"设备坏了",但没有哪个会因为"最近老坏"就自己长出一条新规则。这就是"会演化"的字面含义。
语义层让数据活起来,行为层让数据动起来,动态层让模型长起来;往下是 Language/Engine/Toolchain 与 OSv2 读写分离、增量索引的真实后端;再往下是为"行动"的可靠性选择重物化的取舍。它不是"知识图谱加脚本",是把整个数据操作系统重新组织了一遍。
回环 · 本体如何救大模型
从"数据驱动"到"知识驱动":四大挑战对四种解法,OAG 换掉 RAG 的检索对象,自主性是刻度盘而不是开关——最后回到那笔没人敢批的转账。
- 四挑战 × 四解法
- ODA 本体驱动智能体
- OAG 机制
- 工程链与权限
- 拦截那笔转账
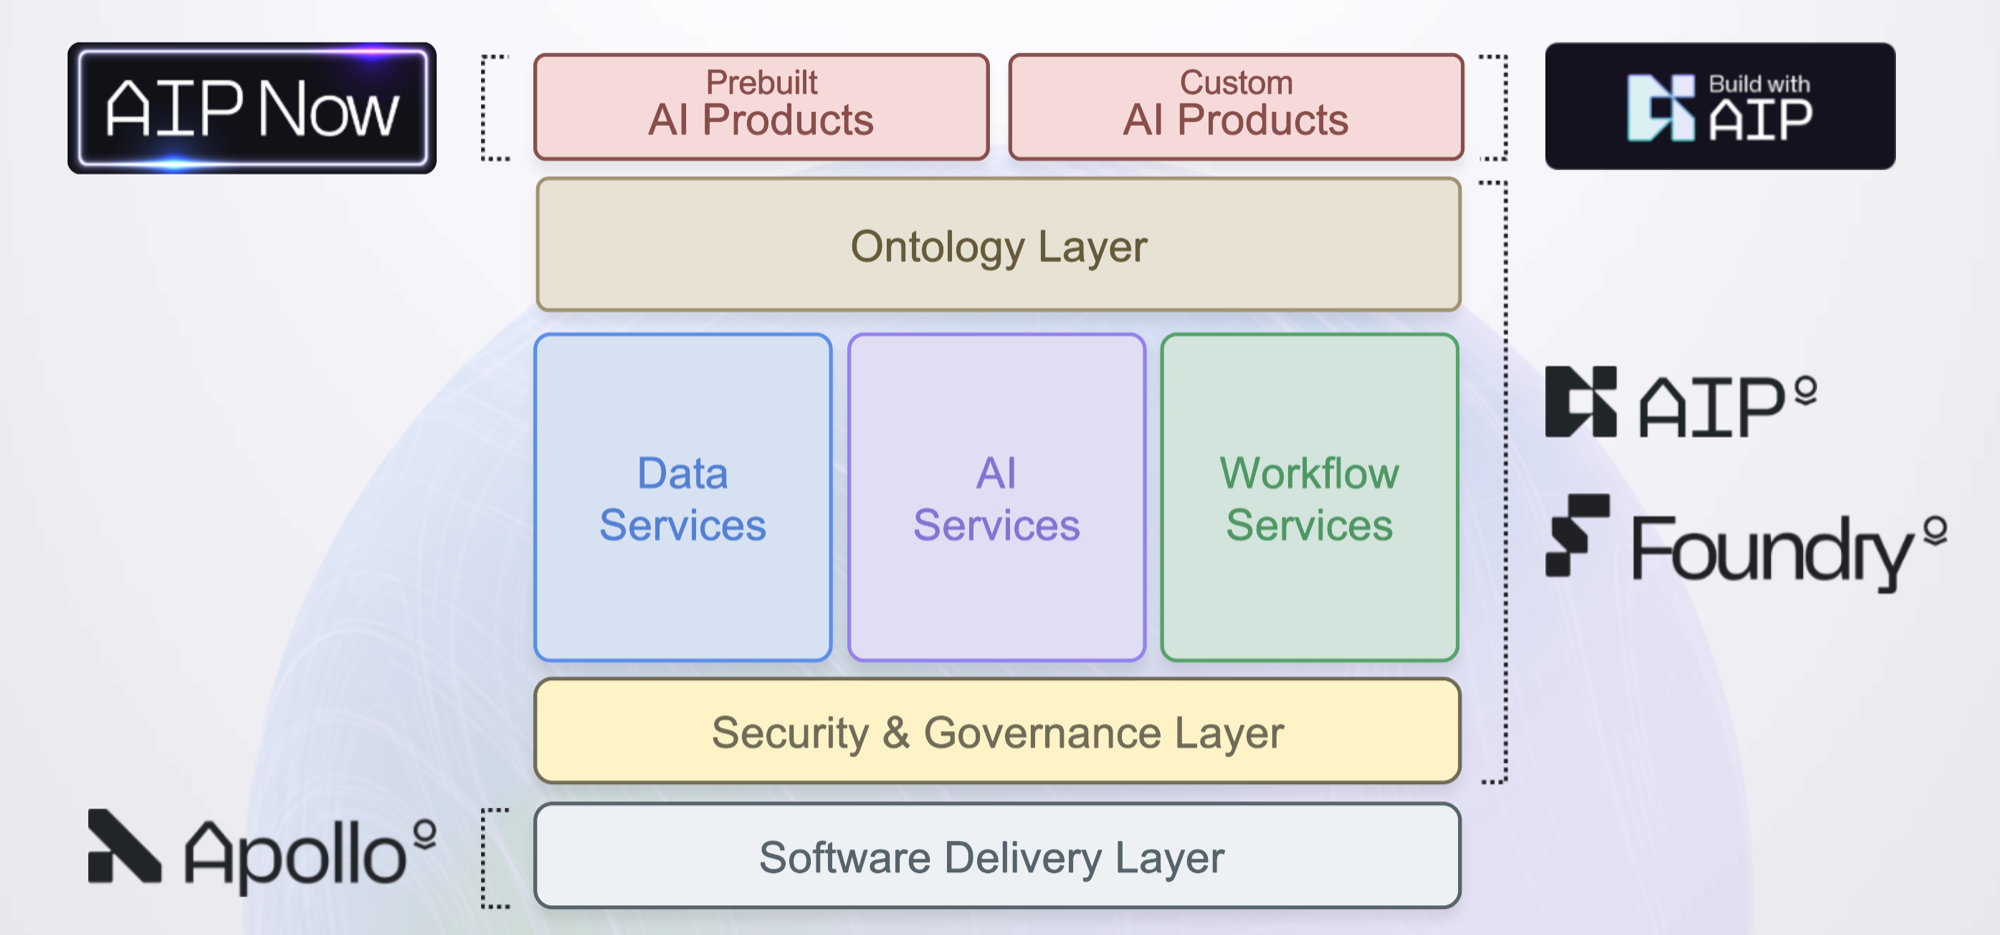
企业 AI 的四大挑战,恰好对应本体的四种解法
传统 AI 是"数据驱动"——从海量数据学模式;本体驱动的核心是"知识驱动"——把隐性分散的规则显性化、结构化,给智能体一个坚实的"世界观"。智能体不再是黑盒,而是在清晰业务地图上行动的导航员。
| 挑战 | 症状 | 本体的解法 |
|---|---|---|
| 语义鸿沟 | 同一概念在 ERP/MES/CRM 表述不一 | 统一语义"翻译层":都映射到标准本体实体 |
| 模型幻觉 | 生成随机、推理黑箱,可能"自信地"违规 | 业务硬约束 + 全链路可解释:决策必过规则校验,可回溯到具体规则节点 |
| 执行断层 | "看得破,管不了" | Action 元素:业务操作封装成智能体可调的接口 |
| 知识沉淀难 | 专家经验困在人脑 | 隐性经验数字资产化:固化成可复用的本体规则 |
| 维度 | 传统知识图谱 | RAG | 本体驱动智能体 ODA |
|---|---|---|---|
| 角色定位 | 被动查询工具 | 文本生成器 | 业务参与者,自主执行 |
| 知识形态 | 静态(实体、关系) | 动态(实时检索的文本) | 动态(实体+关系+事件+逻辑+行为) |
| 推理方式 | 符号推理(图遍历) | 概率推理(LLM 生成) | 符号 + 概率协同 |
| 可解释性 | 高(路径清晰) | 低(生成黑箱) | 高(可追溯至本体规则) |
| 执行能力 | 无 | 无 | 有(Action 驱动业务系统) |
OAG:把"检索文本块"换成"检索业务对象"
RAG 把文档切块、算向量、按余弦相似度捞"长得像"的文本;OAG(Ontology-Augmented Generation)强制 LLM 通过受治理的本体检索带类型的对象。差异落在四个机制上。
- ① 结构化检索经 OSS 拿到类型化对象、确定性属性值、显式关系边——不是相似度排名的文本片段
- ② Schema+权限约束检索结果受本体 Schema 和调用者权限裁剪。"检回三年前已废弃的提案当最新方案用"这类 RAG 经典事故被结构性消除
- ③ 确定性工具调用数学和优化不让 LLM 硬算:AIP Logic 识别出子任务,经本体函数调 NVIDIA cuOpt(供应链优化)、Prophet(时序预测),只把验证过的输出交回 LLM 做语言合成。LLM 从"全能推理器"重新定位为"协调器":任务分解、工具编排、结果解释
- ④ 完整溯源每次推理可回溯到具体对象、属性与关系边——答案不是"模型觉得",而是"依据在此"
幻觉从高到低(减少不是消除,LLM 本质仍是概率的);权限从文档级到对象/属性级;实时性从"向量索引更新"到 OSS 直读;行动力从"只能生成文本"到"能触发 Action"。k-LLM 架构按任务复杂度与治理约束在 xAI/OpenAI/Anthropic/Meta/Google/自托管间路由——LLM 是可替换组件,价值沉淀在本体、治理与编排层。
围绕 OAG 的完整工程链,与"继承来的权限"
- AIP Logic低代码 LLM 函数编排器。输入本体对象或字符串,输出对象或本体编辑;写回两档——自动应用 或 暂存待人工审核;可由 Automate 定时/事件驱动
- AIP Evals把非确定性系统拉回工程纪律:同一提示跑数百次做统计评估,用生产实际数据测边缘情况;内置精确匹配/正则/Levenshtein 评估器,复杂判断用 LLM-as-a-Judge 按标准打 1–5 分;追踪多次执行的方差——方差高说明提示或标准不稳定,不许上生产
- Agent Studio配置多个专业化 copilot 组成协调网络,以本体为安全的共享交换媒介,每个 Agent 有自己的领域知识和操作权限
- 对象监视器持续评估对象状态(库存低于阈值、生命体征异常),条件满足即自动触发通知与动作——"动词"体系里的哨兵
Agent 权限没有另起炉灶
- 从人类用户或项目的权限结构继承:数据访问受与人类相同的安全策略管控
- 可调用的逻辑资产受权限约束,行动范围可精确限定,全部活动进遥测日志
- 官方对 Data–Logic–Action–Security 四重集成的量级描述:实时协调数万名人类与 Agent 的细粒度策略
Ontology 建模的是决策,而非数据。
从增强到自动化:一个刻度盘,不是一个开关
Tampa General 医院三级递进:L1 数据协调("患者-房间-床位"统一运营孪生)→ L2 语言接口(OAG 自然语言查实时状态)→ L3 自主 Agent(监控、起草、协调、告警——只把最终批准留给人)。配套哲学是"默认暂存":动作默认暂存移交人类终审;随日志与运营数据积累,组织再挑受信任、经充分测试的流程放开自动闭环——自主权范围动态扩缩,变更即时生效。
从 System of Record 到 System of Action:循环及其副产品
SAP 们记录"发生了什么",这个循环参与"接下来做什么"。更要紧的是副产品:决策数据——这是第二节"线性 vs 循环"的完整闭环。
决策数据回头变成
- 微调训练集
- Agent 提示词里的目标原则
- 代理的长短期记忆
- 人与 Agent 同权访问、同策略管控
部落知识被显性化,形成决策中心学习:经典本体回答完问题就结束,操作本体把每个答案变成下一个问题的训练数据。
本体与大模型不是替代:本体提供确定性与约束(结构化知识、业务规则、可追溯依据,限定行为边界),大模型提供灵活性与生成(语言理解、框架内规划、应对长尾)。一个管"不许越界",一个管"聪明地把事办了"。
回到那笔转账:硬约束是怎么拦住 AI 的(Knora 案例)
场景是"工单产量变更须经审批",逻辑和转账一模一样。把"工单产量"换成"转账金额"、"20% 阈值"换成"10 万元风控线",就是开篇那个问题的可交付工程答案。
- 第 ③④ 步的"拦截 + 暂存待审"并非案例独创——正是 AIP Logic 写回的"暂存待人工审核"模式与"默认暂存"哲学的同一机制
- AI 可以提议,但提议必须穿过本体的规则校验;违规指令在落库之前被拦下
- 每一次拦截都能回答"为什么"——精确到具体规则节点
开篇不敢做的事——让 AI 独立审批百万转账——现在有了可交付的工程答案:不是让模型更听话,而是让系统结构性地不允许它越界。
最后泼一盆冷水:成本、锁定,与"治理才刚开始"
这正是第一节"刻意淡化成本"那重盲视警告过我们的。国内没有统一的本体理论体系与落地标准;市面上的"本体论落地"多是范式:数据治理口径归一 / 资产静态建模 / 语义约束治幻觉 / 以及最需警惕的——集成商蹭概念,旧东西换皮当本体卖。
锁定不是合同条款,是架构性质(三层)
- 本体无法脱离 Foundry 独立运行——没有导出后另起炉灶的机制
- 数据必须经 Funnel 物化集成——不能只是"引用"
- 不同本体实例之间无法建立链接——联邦化部署里,供应链本体的"供应商"连不上财务本体的"应付账款"
让受控写入、决策捕获、统一权限面成立的操作耦合,就是让你走不掉的耦合——管道故障时,本体的读写一起停。护城河与其说是 AI,不如说是"先做脑外科手术、再长成中枢神经系统"的集成工程:初始建模痛苦漫长,一旦嵌入,切换成本高到接近器官移植。
三句诚实的话
- Hacker News 上"这不过是面向对象编程"的嘲讽反而点破要害——价值不在理论新颖,在执行深度
- 本体上线不是终点而是起点:模型随业务漂移,一次变更会级联影响应用、函数、API 和 Agent——本体上线之日,才是治理开始之时
- 它不是银弹:很多场景下,轻量 Schema 加提示词工程反而更划算。跳出来看清整头象,才不会把某一条腿当成大象本身
本体是块硬骨头:牵涉语义、操作、演化,早已不是躺在论文里的学术概念;要真做好,是一场持久战。
OWL 让机器理解世界,
知识图谱帮机器检索世界,
而 Palantir 的本体,让机器在你划定的规则里改变世界——
再随世界一起,改写自己。
方向是清楚的;但请带着第一节的四重"盲视"疫苗、第五节的锁定账本,清醒地上路。